一篇于 2026 年 8 月 7 日提交到 arXiv 的研究提出 EMAS(Evidence-guided Multi-Agent System evolution),讨论如何在不更新 LLM 参数的情况下,让多智能体系统根据过往执行经验逐步修正。研究作者包括 Chao Fei、Qingyi Si、Kaihua Liang、Yanghua Xiao、Panos Kalnis 和 Hongcheng Guo。
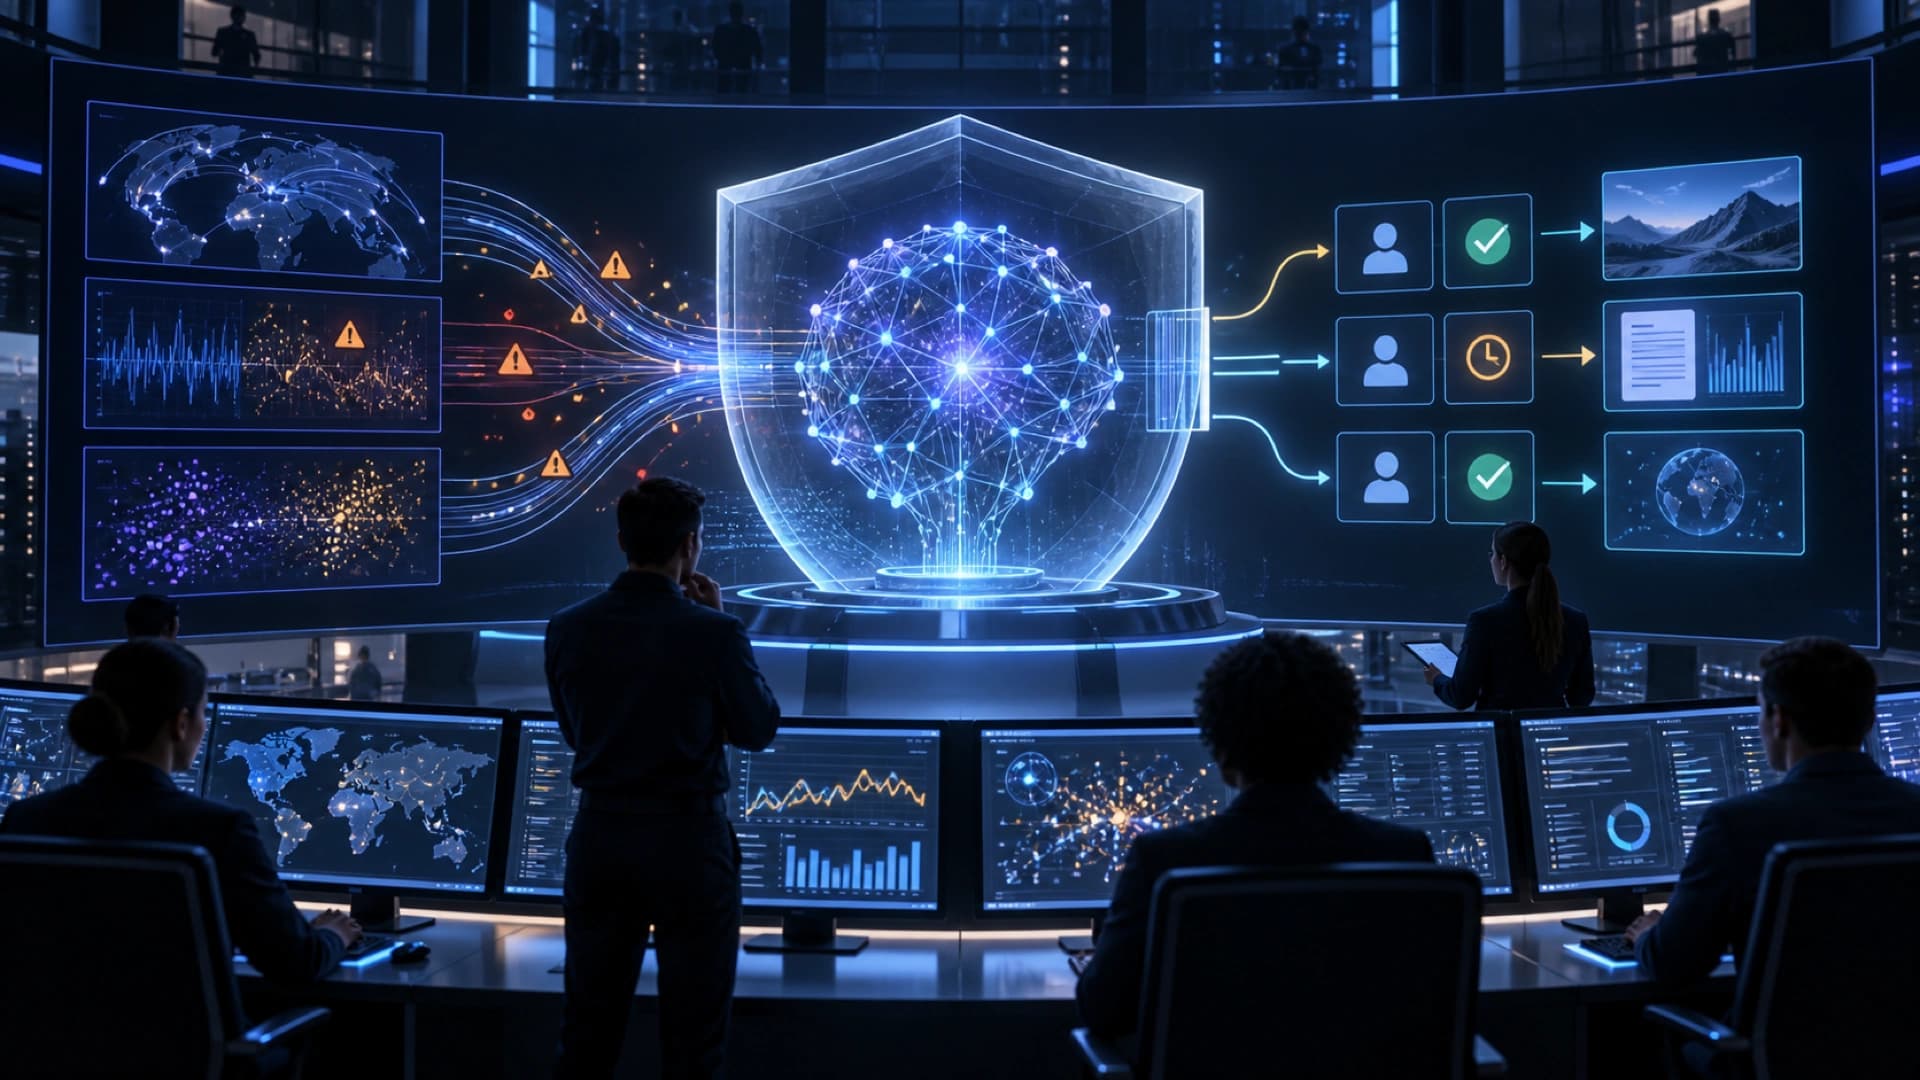
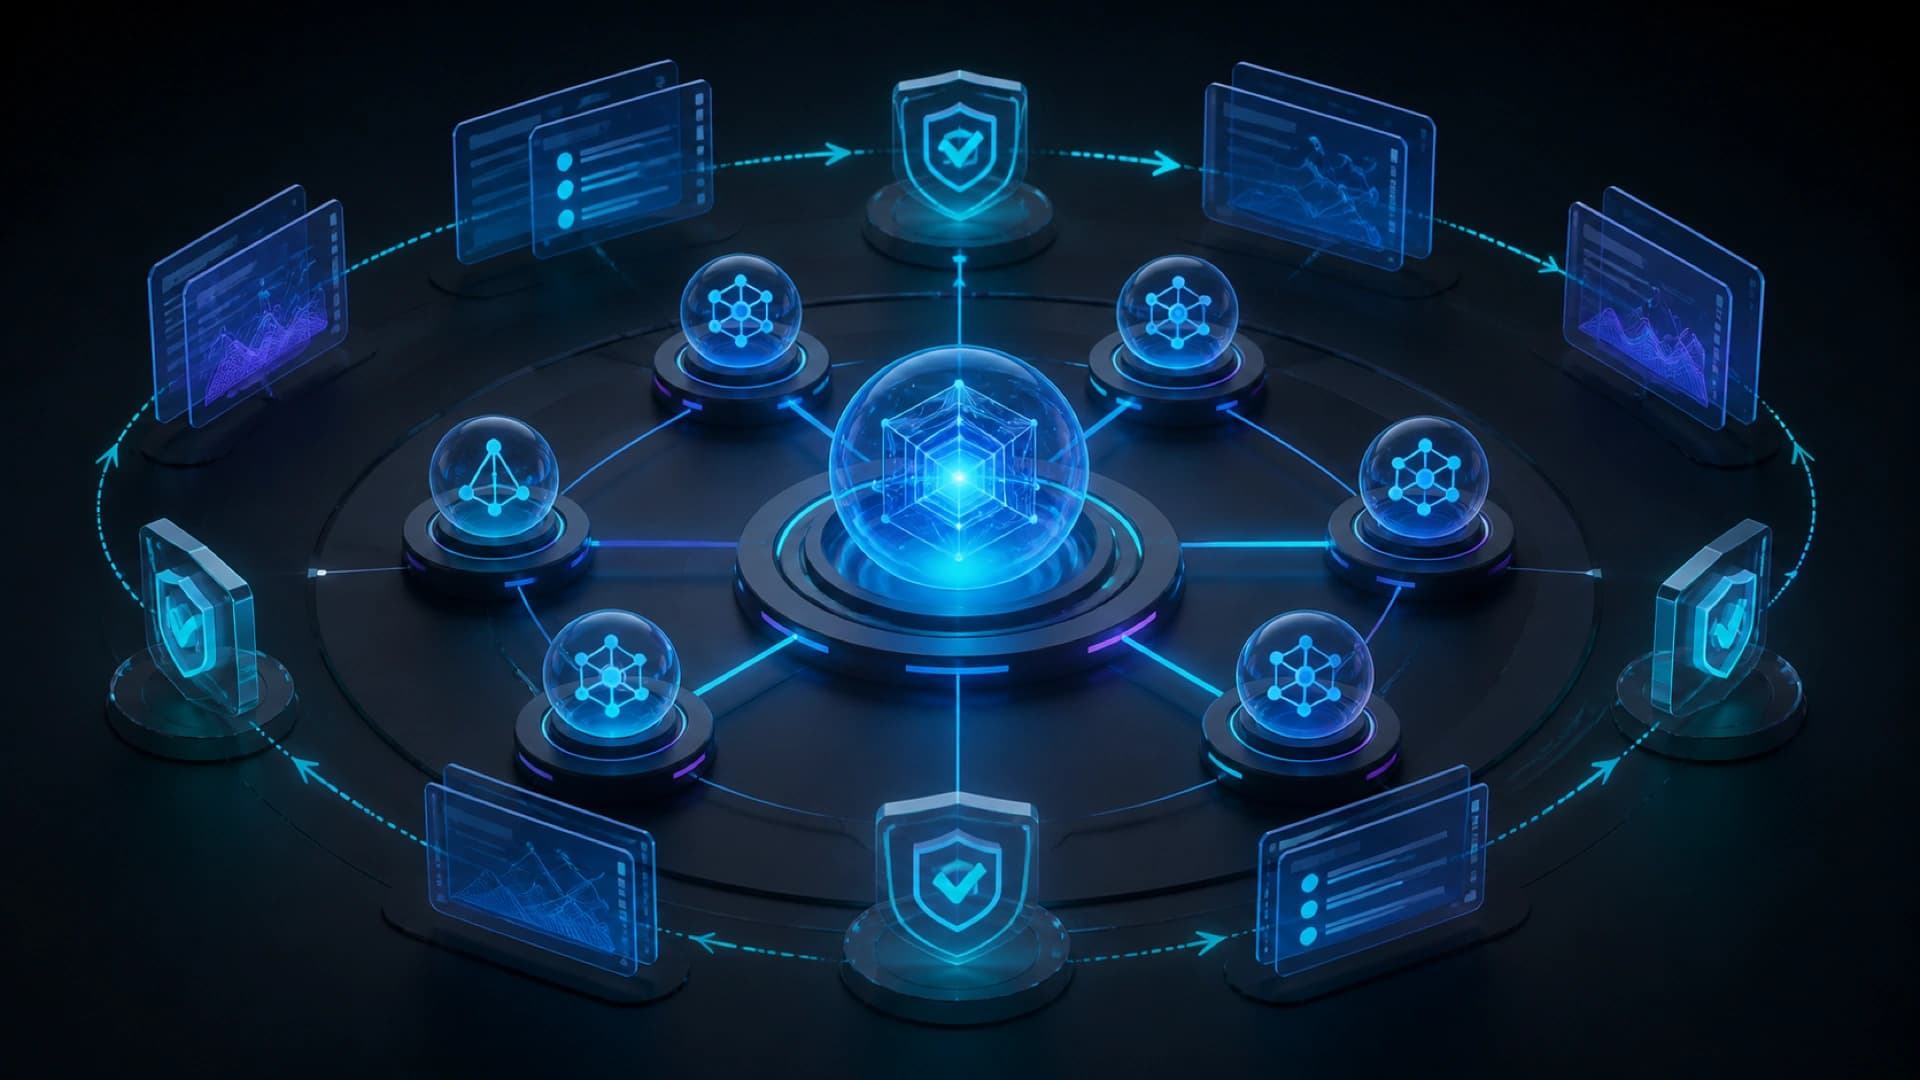
EMAS 的核心不是让一个模型自行重写整个系统,而是把 execution traces 转成结构化诊断。当相同问题在不同任务中反复出现时,系统才会生成候选 revision,例如调整 agent topology 或修改 prompt。候选版本还要通过 paired validation 才会被接受。这个门槛用来减少一次失败就改动架构,让演化过程更容易追踪和回滚。
这种方法和只靠 prompt trial-and-error 有明显区别。它把失败经验、问题诊断、候选变更和验证结果分开保存,让团队可以知道一项改动针对哪种 recurring diagnosis,以及改动后是否真的改善同类任务。对于 production workflow,这些中间证据也可以接入版本控制、审批和 audit log。
论文报告在 4 个 benchmark 和 2 个 LLM 上测试,EMAS 在 8 个设置中有 6 个取得最佳或并列最佳表现。作者还报告,在 Kimi-K2-6 和 Qwen3.6-27B 上分别取得 6.30% 和 20.10% 的相对提升;在 MBPP 的一个 Qwen3.6-27B 设置中,结果从 55.09% 提升到 89.12%,token 使用量下降 62.2%。这些都是论文报告的实验结果,并非独立生产环境验证。
EMAS 的实际价值不只在分数提升,更在于它把「改良 agent workflow」变成有条件的控制回路。团队可以要求每次 revision 都保留原版本、明确列出诊断、通过固定回归集,并在成本、延迟和安全指标没有恶化时才晋级。这比让 agent 在没有护栏的情况下持续自我修改更适合受监管流程。
但 evidence-guided 不等于 evidence-complete。如果 traces 本身漏记工具错误、租户信息或权限结果,诊断就可能指向错误原因;paired validation 也可能只覆盖已知任务,无法捕捉新型输入。要在真实系统采用,仍需要数据脱敏、固定 evaluation set、灰度发布、rollback 和人工 review。
这项研究反映多智能体系统的下一个问题,可能不只是「模型是否更强」,而是「系统能否从失败中有纪律地变好」。把 traces 转成可验证的修改建议,可以让 agent workflow 更接近一般软件工程的测试、版本化和发布流程;同时也提醒团队,系统演化本身需要权限和审计。