2026 年 8 月 17 日提交的 arXiv 预印本 GenRouter,处理一个很实际的 AI workflow 问题:图像 Agent 不应该对每个 prompt 都运行同一条最重的 pipeline。现有系统通常各自建立 search、reasoning、verification 或多轮生成流程,结果是能力互相分散,简单请求也被迫支付复杂流程的计算成本。
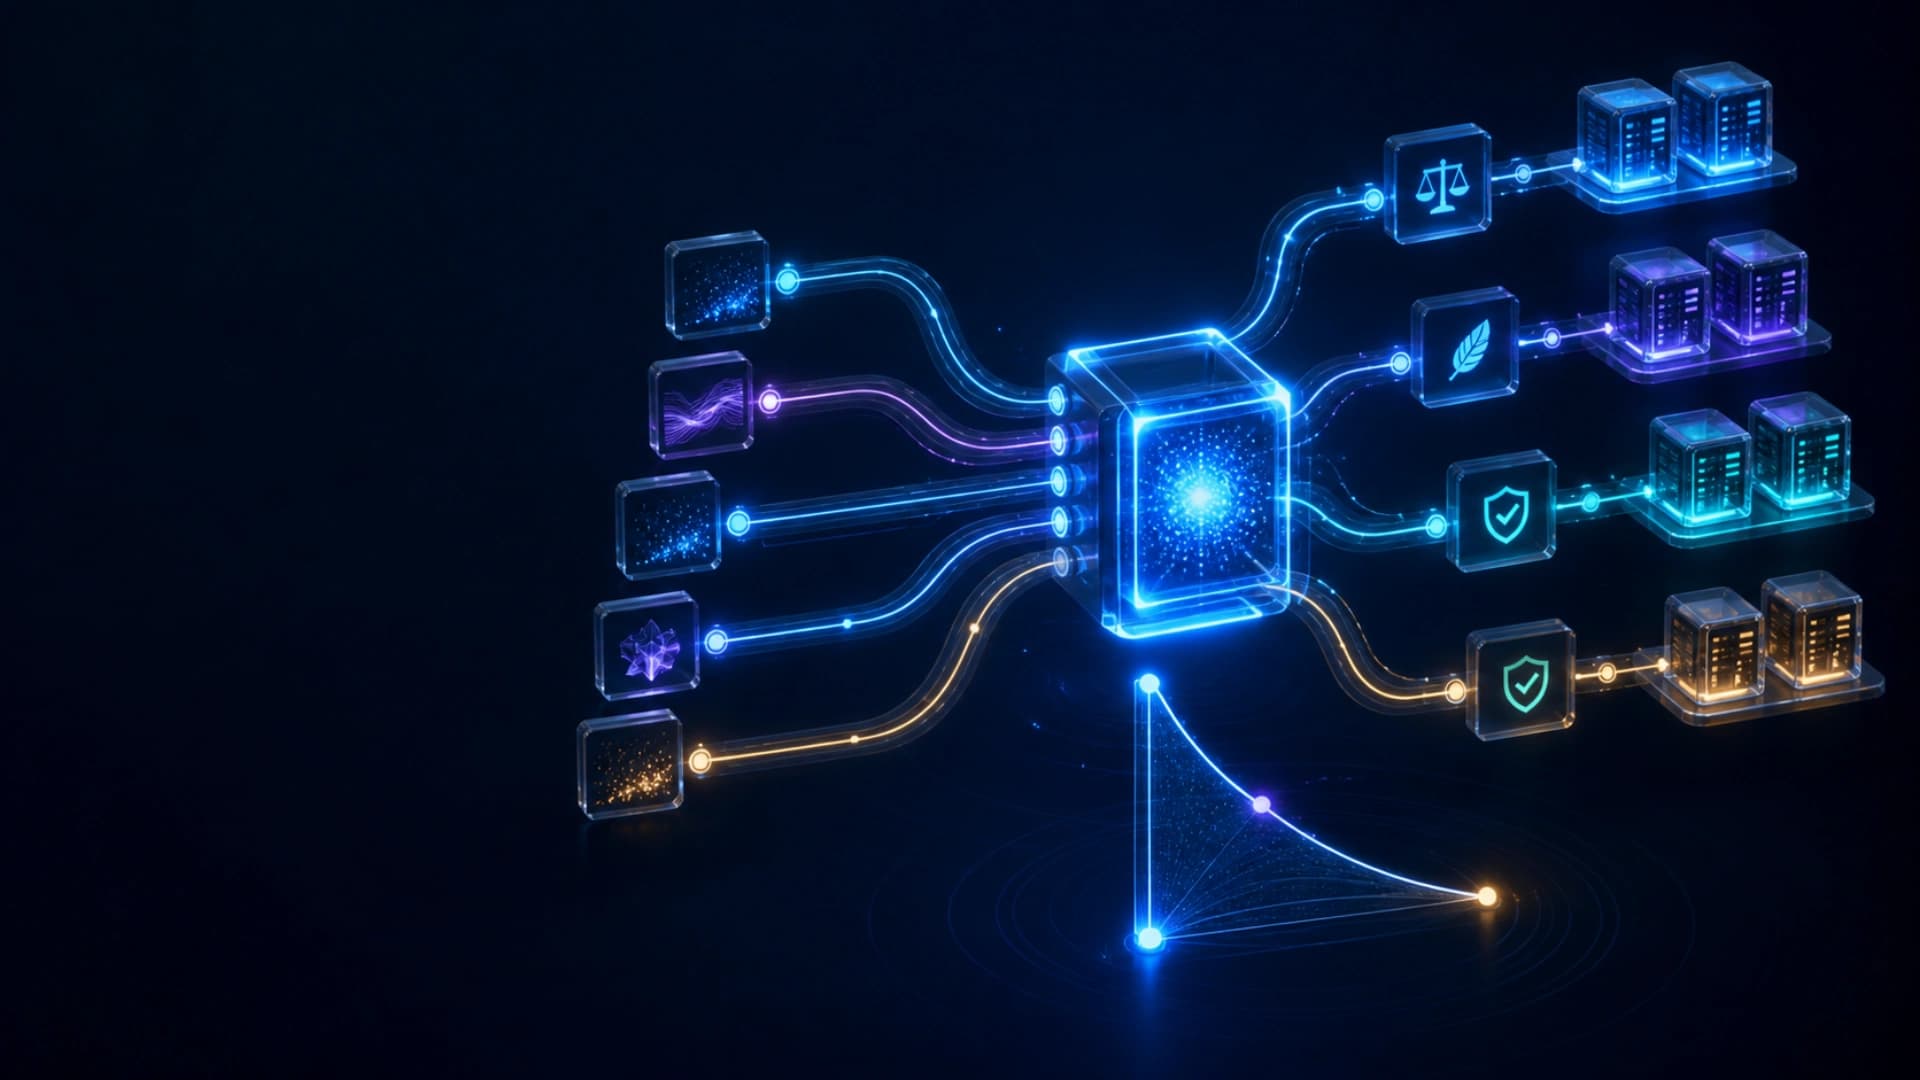
研究团队提出 GenCanvas,把不同 agentic image pipeline 统一成一组 foundational primitives 和 executable templates;GenRouter 再根据 prompt 做 demand profiling、experience matching 和 Pareto filtering,选择一个兼顾视觉质量、成本和 latency 的 workflow。这个设计把「模型生成什么」和「应该先做哪些步骤」分开,路由器本身成为可评估的决策层。
作者在五个 benchmark 的平均结果中报告,GenRouter 配合 GenCanvas 达到 71.3% 整体表现,与 GEMS 这类较重 pipeline 比较时,execution cost 由 59.70 美元降至 2.97 美元,latency 由 13.62 小时降至 4.68 小时。这些是论文作者自建实验的数字,benchmark、模型、API 价格和执行环境都会影响结果,不应直接当成所有图像服务的成本保证。
路由的核心不只是便宜。论文显示,注重美感的 prompt 较常使用轻量的文字 enhancement workflow,而有复杂空间或逻辑限制的 prompt,才较常进入 reasoning、hybrid 或 verification 模板。对于 workflow 设计,这是一个重要分工:昂贵的检查和多轮修正应该按需求开启,而不是默认套用。
研究也测试了经验累积。加入三个 benchmark 的 routing experience 后,混合测试集表现由 73.5 提升至 75.2,同时 cost 和 latency 分别下降 8.7% 和 7.9%。在另一个 zero-shot transfer 测试中,作者报告 frozen experience 已能比 standard LLM-as-Router 有更高表现和更低成本。这些结果仍属预印本,需要由其他团队以不同模型和 prompt 分布重现。
对于实际内容 workflow,GenRouter 的启示是先把任务分成简单、受约束和高风险三类,再为每类设计最低可行步骤、可选 verifier、成本上限和人工 review。路由决策也要留下理由、使用的 template、重试次数和输出质量,否则省下的 token 很快会被难以追查的失败和人工返工抵消。
这篇研究把 agentic image generation 的竞争焦点由「单一模型有多强」推向「系统是否能按需求分配计算」。对于 AI marketing、设计和内容团队,可靠的 workflow 不等于每次都用最长推理;更合理的做法是让复杂度、验证和成本随任务风险变化,并用 held-out prompts 验证路由器没有只记住 benchmark。