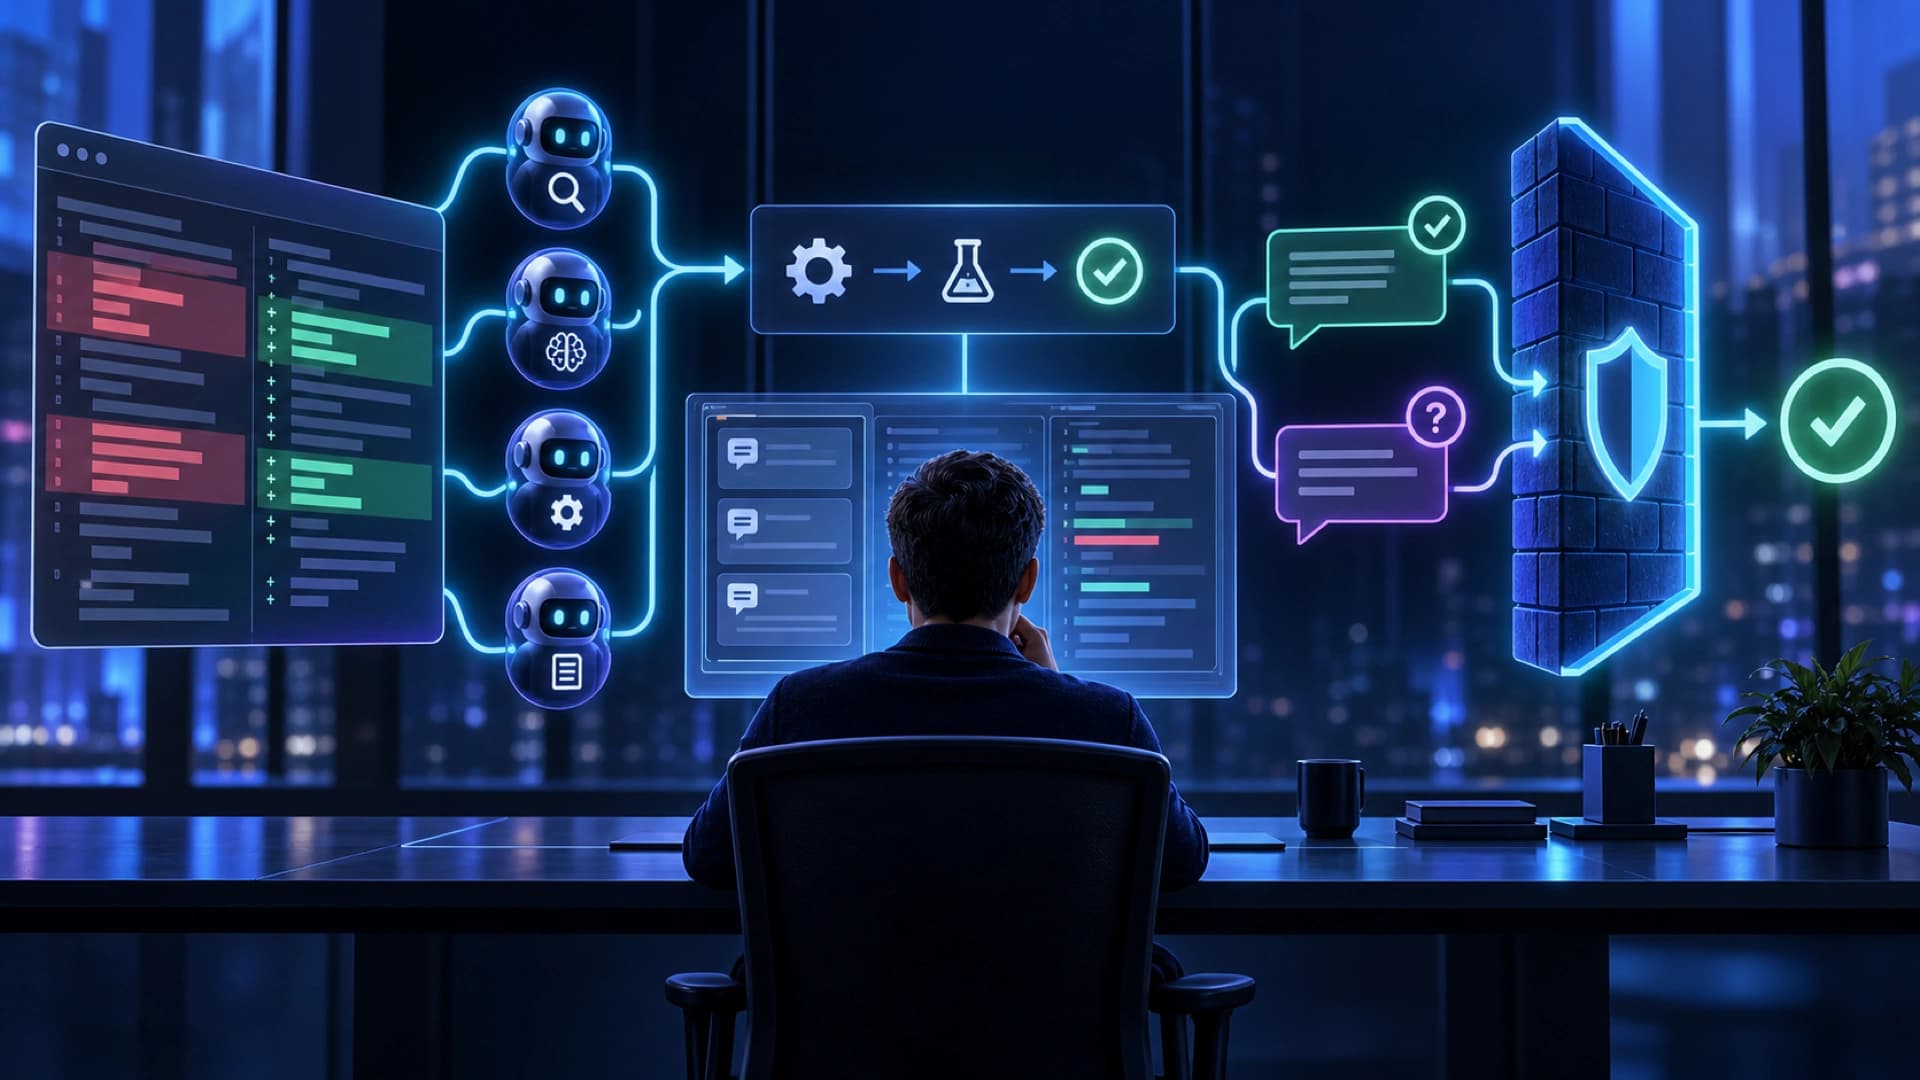
GitHub 于 2026 年 9 月 11 日公布 Copilot Code Review 的一组更新:后续 commit 已处理底层问题时,系统可以自动解决相关 review comment;应用 Copilot 建议时可以生成 smart commit message;review agent 也获得更多分析工具。这些变化把 code review 由一次性留言,推向可以跟随 pull request 状态变化的工作流。
自动解决的规则仍然有边界:后续 commit 被判定已处理的意见会关闭,尚未处理的 outstanding comments 会继续打开。这能减少开发者在重复检查已修正项目上的整理成本,但「意见已解决」不等于「修改一定正确」。人仍需要查看差异、测试和上下文,尤其是涉及安全、数据迁移或业务规则的变更。
分析能力方面,review agent 现在可以使用 Copilot SDK 提供的完整 shell tools,并置于 Copilot agent firewall 后面,用来执行 builds、tests、targeted scripts,以及获取可用的 tool 或 API 信息。工具权限、执行环境和可读数据由平台设置决定;这不代表所有 repository 都会自动获得相同工具,也不代表测试通过就证明整个修改符合产品要求。
GitHub 也表示 Lite effort level 现在会使用 agent ensemble,把多个 agent 的观点合并。官方实验数据显示,高严重度意见的处理量增加 47%,中严重度增加 31%,低严重度增加 11%,review 成本约降低 8%。这些是 GitHub 自己的实验结果,应视为供应商披露的方向性信号,而不是适用于所有团队的独立 benchmark。
值得留意的产品转向,是 review agent 不再只负责生成静态评论,而是开始进入「提出问题、执行验证、更新状态」的循环。构建和测试可以提供比语言模型直觉更好的证据,但测试套件的覆盖范围有限,shell 命令的成功也不等于商业正确性。工程团队仍要决定哪些检查可以由 agent 自动完成,哪些必须由人批准。
安全和治理边界应该同步设计。Copilot agent firewall、tool allowlist、秘密管理、branch protection、必要的 code owner review 和可重现命令,都应该成为正式流程的一部分。这次公告没有声称能覆盖所有风险,因此企业不应把 agent 的工具权限直接等同于 CI/CD 或 production 权限,也不应让敏感凭证因测试方便而暴露。
采用后的量度也不能只看自动关闭了多少 comment。更有用的指标包括 false positive 和 false negative、开发者接受率、解决准确度、review latency、执行成本、回归缺陷,以及人工重新打开意见的比例。如果 Lite ensemble 让结果更完整但消耗更多运算,团队应以每个有效合并或每个高价值缺陷的成本比较,而不是只看单次调用价格。
整体而言,GitHub 正把 AI code review 嵌入 pull request 的状态循环:代理可以提出观察、调用受控工具、等待后续 commit,再更新自己的意见。这会减少部分机械性整理,但 merge、release 和例外处理的责任仍在工程团队。真正的成效,取决于工具边界、测试质量、人工复核和可追溯性是否一起落地。