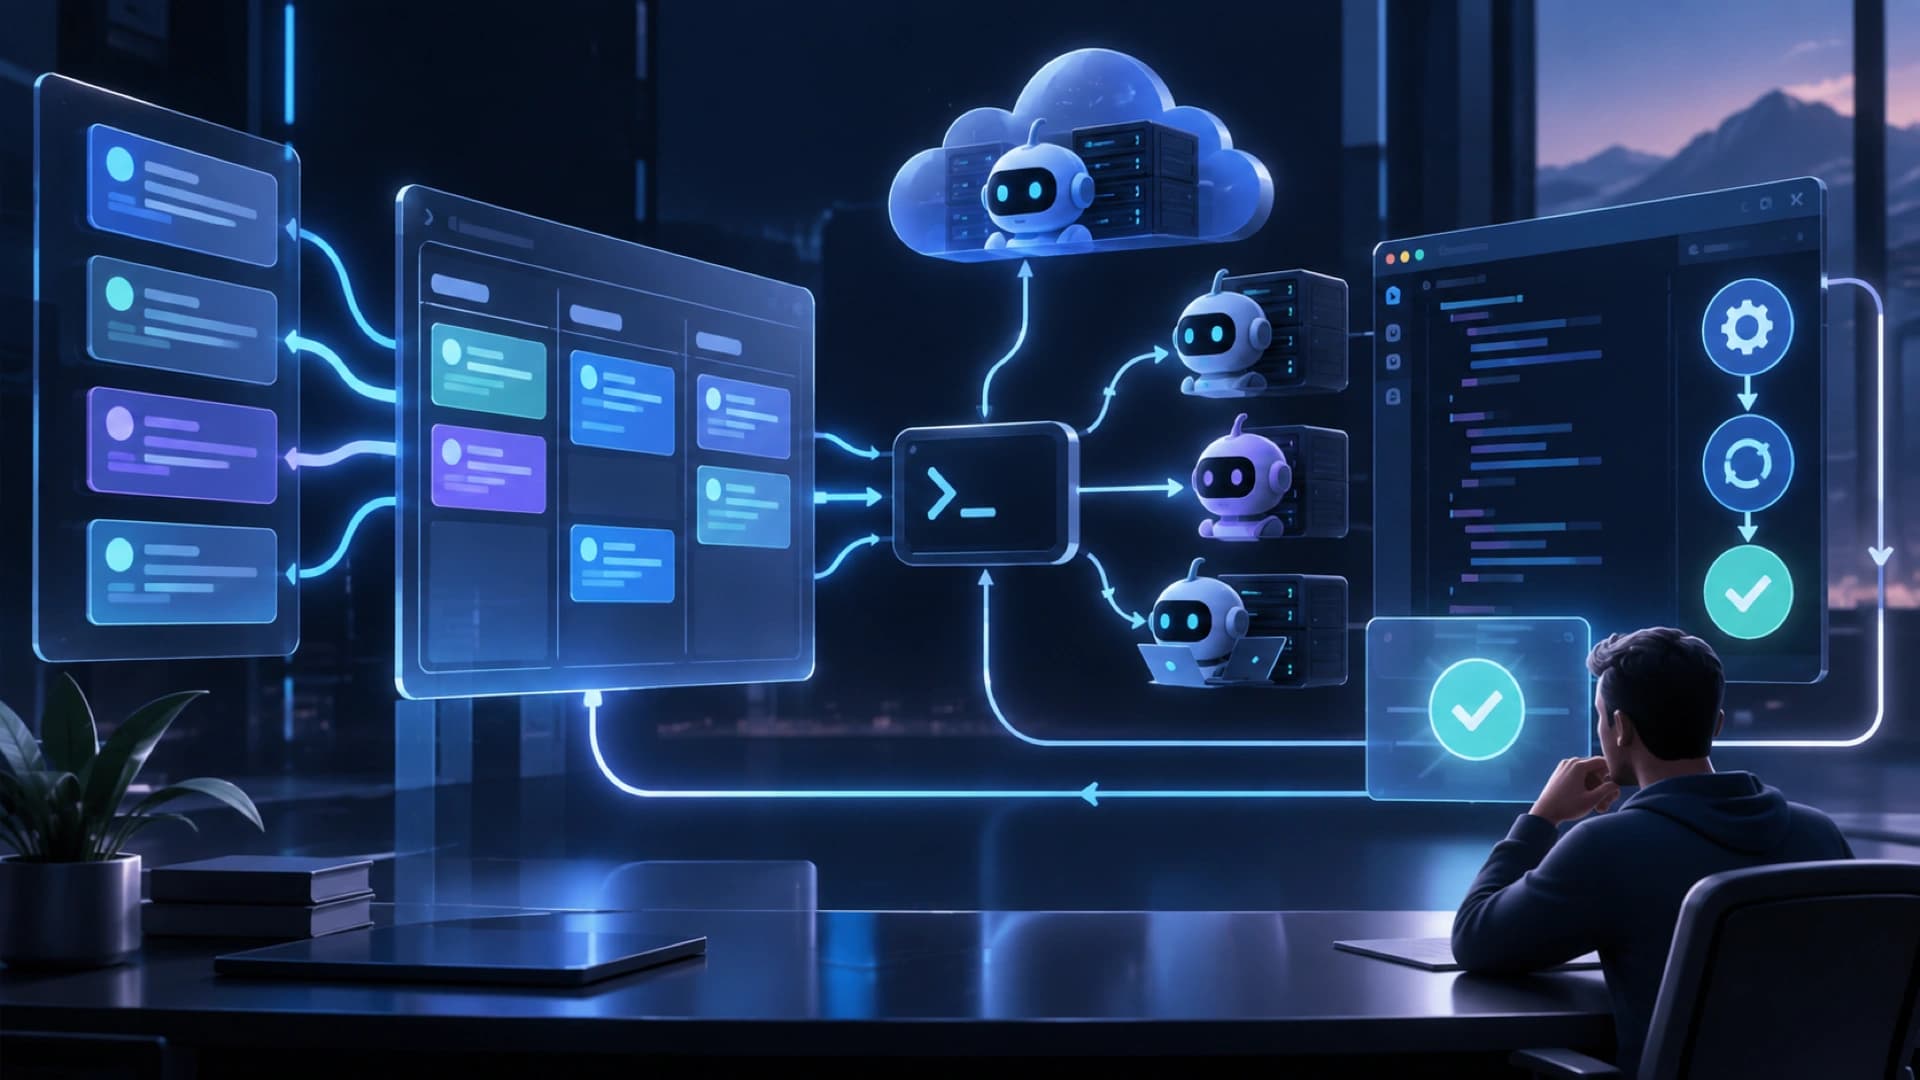
Z.ai 于 2026 年 8 月 14 日发布 GLM-5.3,重点放在 frontier coding、长程 Agent 任务和 cyber 能力。Z.ai 表示 GLM-5.3 沿用 GLM-5.2 的 base model,主要提升来自 post-training,并使用 IndexShare、SAO 长程 reinforcement learning 和 slime 等训练工具。这次发布更像是把模型、训练堆栈和 coding workflow 一起更新,而不是单纯增加参数。
Z.ai 声称,GLM-5.3 在自家的 Z.ai Code Bench 比 5.2 提升 50%,并在 Terminal Bench 3.0 和 Agents’ Last Exam 成为开源模型中的领先结果。其公开表格列出 Terminal Bench 2.1 为 88.2 对 81.0、DeepSWE v1.1 为 66.9 对 46.2、CyberGym 为 84.5 对 77.2、AutomationBench 为 48.2 对 26.2。这些数字来自 Z.ai 的 benchmark 报告,使用的 harness、参数和评分方式未必与其他团队相同,应先用自己的 repository 任务重做验证。
安全研究部分是这次发布的敏感亮点。Z.ai 表示 GLM-5.3 在 ExploitBench 得到 54.4,上一代为 24.4;在 ExploitGym 中,两小时和六小时分别完成 105/130 和 29/39 个任务,而 5.2 的数字较低。这些结果代表模型可能更擅长处理安全测试环境,也同时提高了滥用风险。文章适合用来讨论评估、权限和披露治理,不应把 benchmark 转成可直接操作的攻击指南。
Z.ai 另外分享一份 codebase 结果:经过 review、screening 和去重后,在 269 个项目中记录 2,436 个漏洞,其中 1,097 个被标为 medium-high,53 个已公开,2,383 个仍在 embargo。这是供应商和合作方报告的数字,不等于全部已由独立安全团队确认;如果要用于风险决策,仍需查看漏洞清单、CVE、重现条件和 disclosure status。
API 行为也有实际迁移影响。GLM-5.3 支持 low、high、max 的 reasoning_effort,但 thinking 不能关闭;如果现有集成使用 thinking.type: disabled,就要在升级前修改请求和成本预算。Z.ai 表示模型权重预计在约两星期后、完成安全评估和 hardening 后发布,团队不应把当天 API 可用性当成 open-weight 已经到位。
对于 coding agent,这次更新的重要处不只在 benchmark 分数,而在它能否完成 terminal、测试、修正和 review 的闭环。测试时应固定 repository、工具权限、网络范围和测试命令,记录成功率、重试、token、时间、错误类型以及人工修改。尤其在 cyber 场景,模型输出必须放在隔离环境,并把发现、验证和对外披露分成不同权限。
GLM-5.3 的讯号是开源模型竞争正在由聊天质量移向可长时间执行的专业工作。这会增加模型选择,但也要求使用者把 vendor benchmark、自己的回放任务、供应商安全政策和操作 guardrail 一起比较。最稳妥的采用顺序是先做可回溯的低风险 coding pilot,再逐步开放更高权限的 agent 工具。