Google DeepMind 于 2026 年 8 月 12 日发布 sign-language-to-text 模型 SL2T,并把它带进 Gboard 和 Pixel 11 的 Live Transcribe。首阶段支持 American Sign Language 到英文,Google 表示更多设备和语言会陆续加入。这次更新的重点,不只是新增一个翻译模型,而是让 Deaf 和 hard of hearing 用户可以在原本打字的位置直接用手语输入。
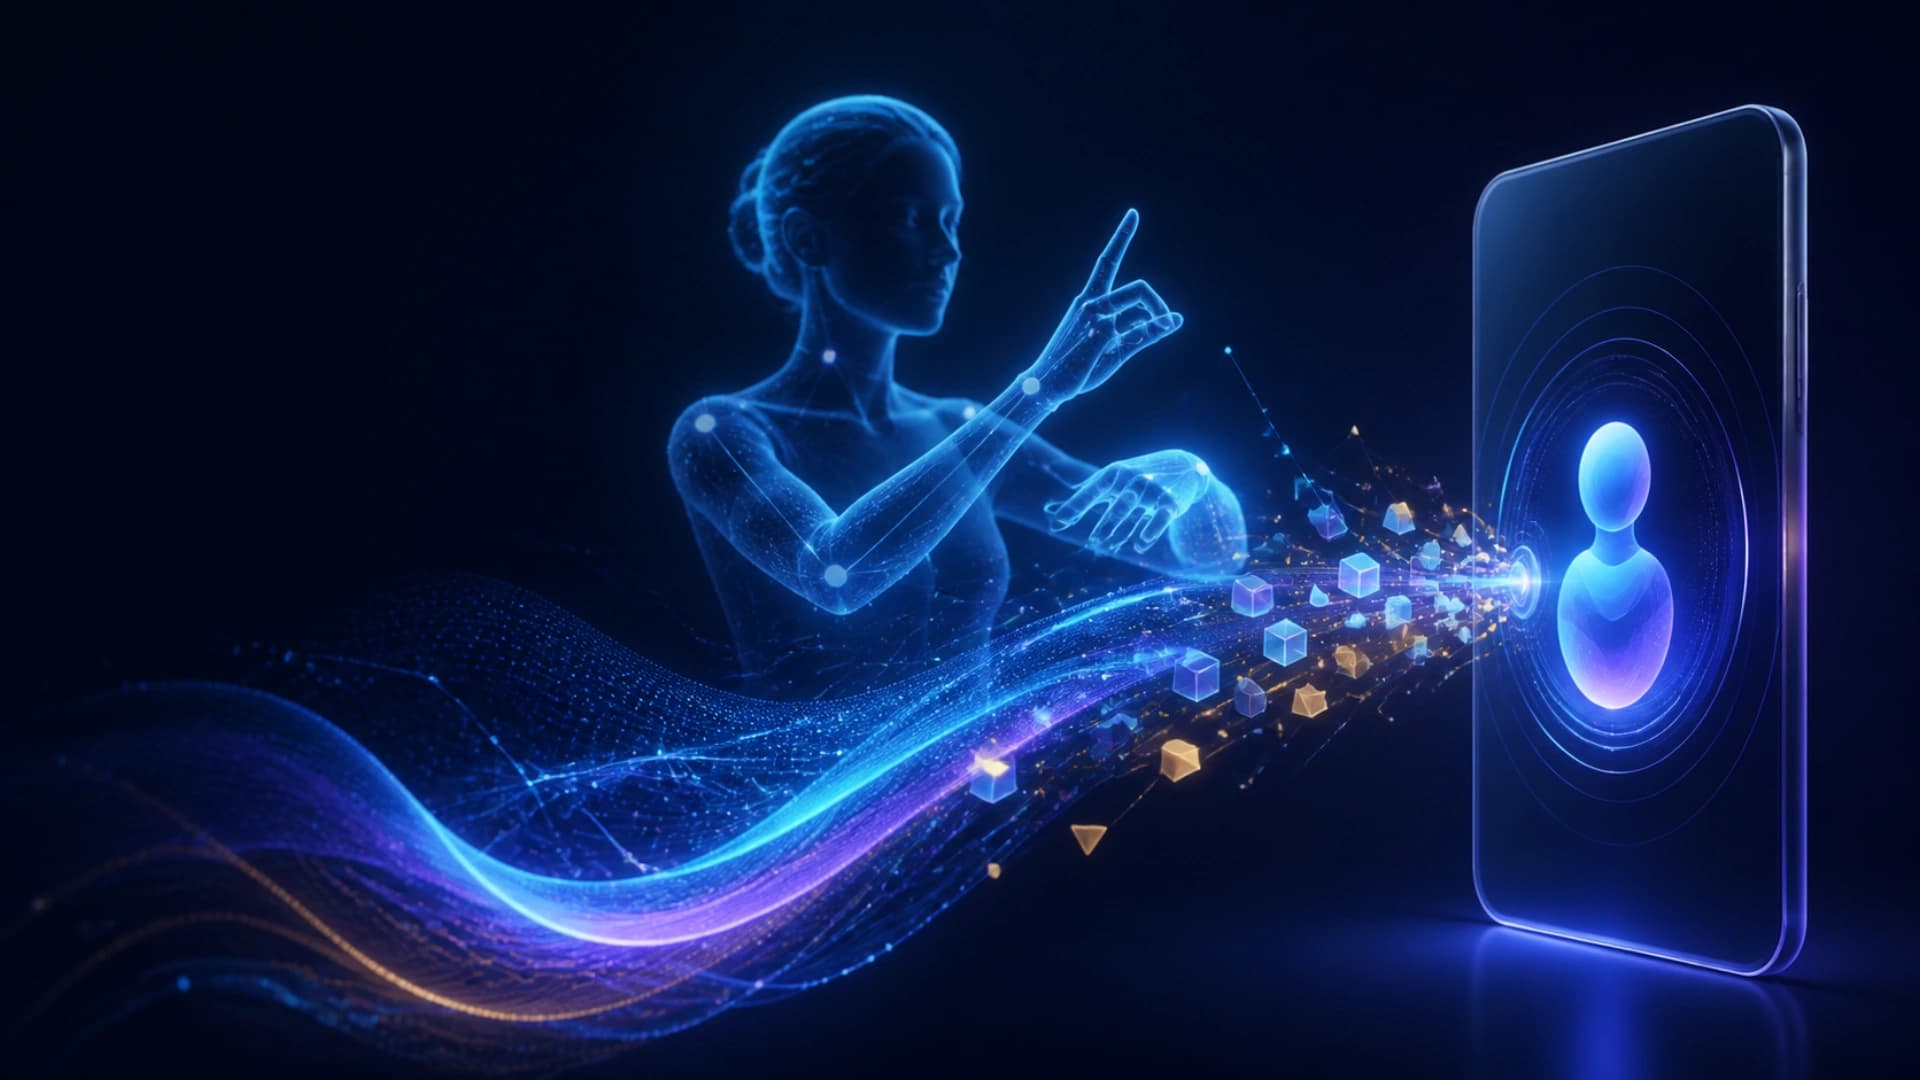
SL2T 可把手语转成文字,让用户用手语搜索网页、撰写消息或文档,也可以要求 Gemini 解答问题或执行任务。在 Live Transcribe 里,用户可以用手语回应对话,减少双方反复打字。这些是 Google 描述的产品场景;实际可用性仍取决于设备、语言、手语熟练程度和现场影像条件。
手语翻译不是把英文词语逐个映射到手部动作。Google DeepMind 指出,手语是有自身 grammar 和 lexicon 的自然语言,意思同时由手、手臂、躯干、头部和面部动作传递;模型要处理高帧率、细微和同步的 computer vision 讯号。这使它更接近真正的 machine translation,而不是简单的 gesture recognition。
在 privacy 设计上,SL2T 不直接把原始 camera feed 送往服务器。Google 表示,设备上的 MediaPipe Holistic 先把手语转成 signer body 的 pose landmark coordinates,再把几何坐标送到服务器翻译,原始视频可以即时丢弃。这种设计降低了原始影像留存风险,但仍然需要说明坐标、传输、服务端处理和账户资料如何受保护。
Google DeepMind 表示,模型使用超过 100,000 小时、覆盖 50 多种手语的数据训练,其中约四分之一是 ASL;团队认为多语言训练有助模型学到共享结构。Google 也报告 SL2T 在 FLEURS-ASL 的 zero-shot score 达到 70 BLEURT,并称是目前最强的手语翻译模型。这是 Google 公布的 benchmark 结果,不能取代不同社群、方言、速度和真实对话中的 user study。
产品化时,团队另外处理 streaming latency、非手语输入时的 hallucination、左手用户,以及一只手拿手机时的 one-handed signing。Google 也表示与 Deaf community 共建,成立 AI Sign Language Advisory Committee,并把能力和限制写入 joint impact report。这些治理安排很重要,因为手语科技的质量不只由 BLEURT 分数决定,也由用户能否自然、可靠和有尊严地使用决定。
SL2T 的更大讯号,是 multimodal AI 正由「看得懂影像」走向「以用户自己的语言直接操作数码服务」。当手语输入可以接到搜索、文档和 Gemini task execution,accessibility feature 也开始具备 agent interface 的特性。下一步的评估应包括不同手语、方言、单手和快速 signing 的准确度、延迟、错误后果、影像处理透明度和用户能否随时控制数据。