NVIDIA 于 2026 年 8 月 11 日公布 Nemotron 3.5 Lightning 和 NeMo Switchyard,把重点放在多智能体系统中两个相关问题:如何用更小、更快的模型处理大量重复工作,以及如何在不重写应用程序的情况下为每个请求选择合适的模型。
Nemotron 3.5 Lightning 是一个 30B 参数的 mixture-of-experts 模型。NVIDIA 将它定位为大型多智能体系统中负责专门任务的模型,例如持续运行的工具调用、数据整理或其他高数量 agent 工作。官方表示,在 PinchBench 比较中,Lightning 的输出速度最高可达同级模型的 4 倍,agent 任务完成速度最高快 30%。这些是 NVIDIA 公布的 benchmark 结果,采用前仍需要用自己的工具链和任务集重新测试。
模型可以使用 NVIDIA NeMo,以领域数据、工具和工作流进行 post-training。NVIDIA 还表示会按许可条件公开训练数据和方法,并发布 Nemotron-RL-Agentic-Terminal-Pivot 数据集,用于 coding agent 的后训练。这种可调整性对企业有吸引力,但也意味着团队要负责数据质量、权限边界和模型更新的维护成本。
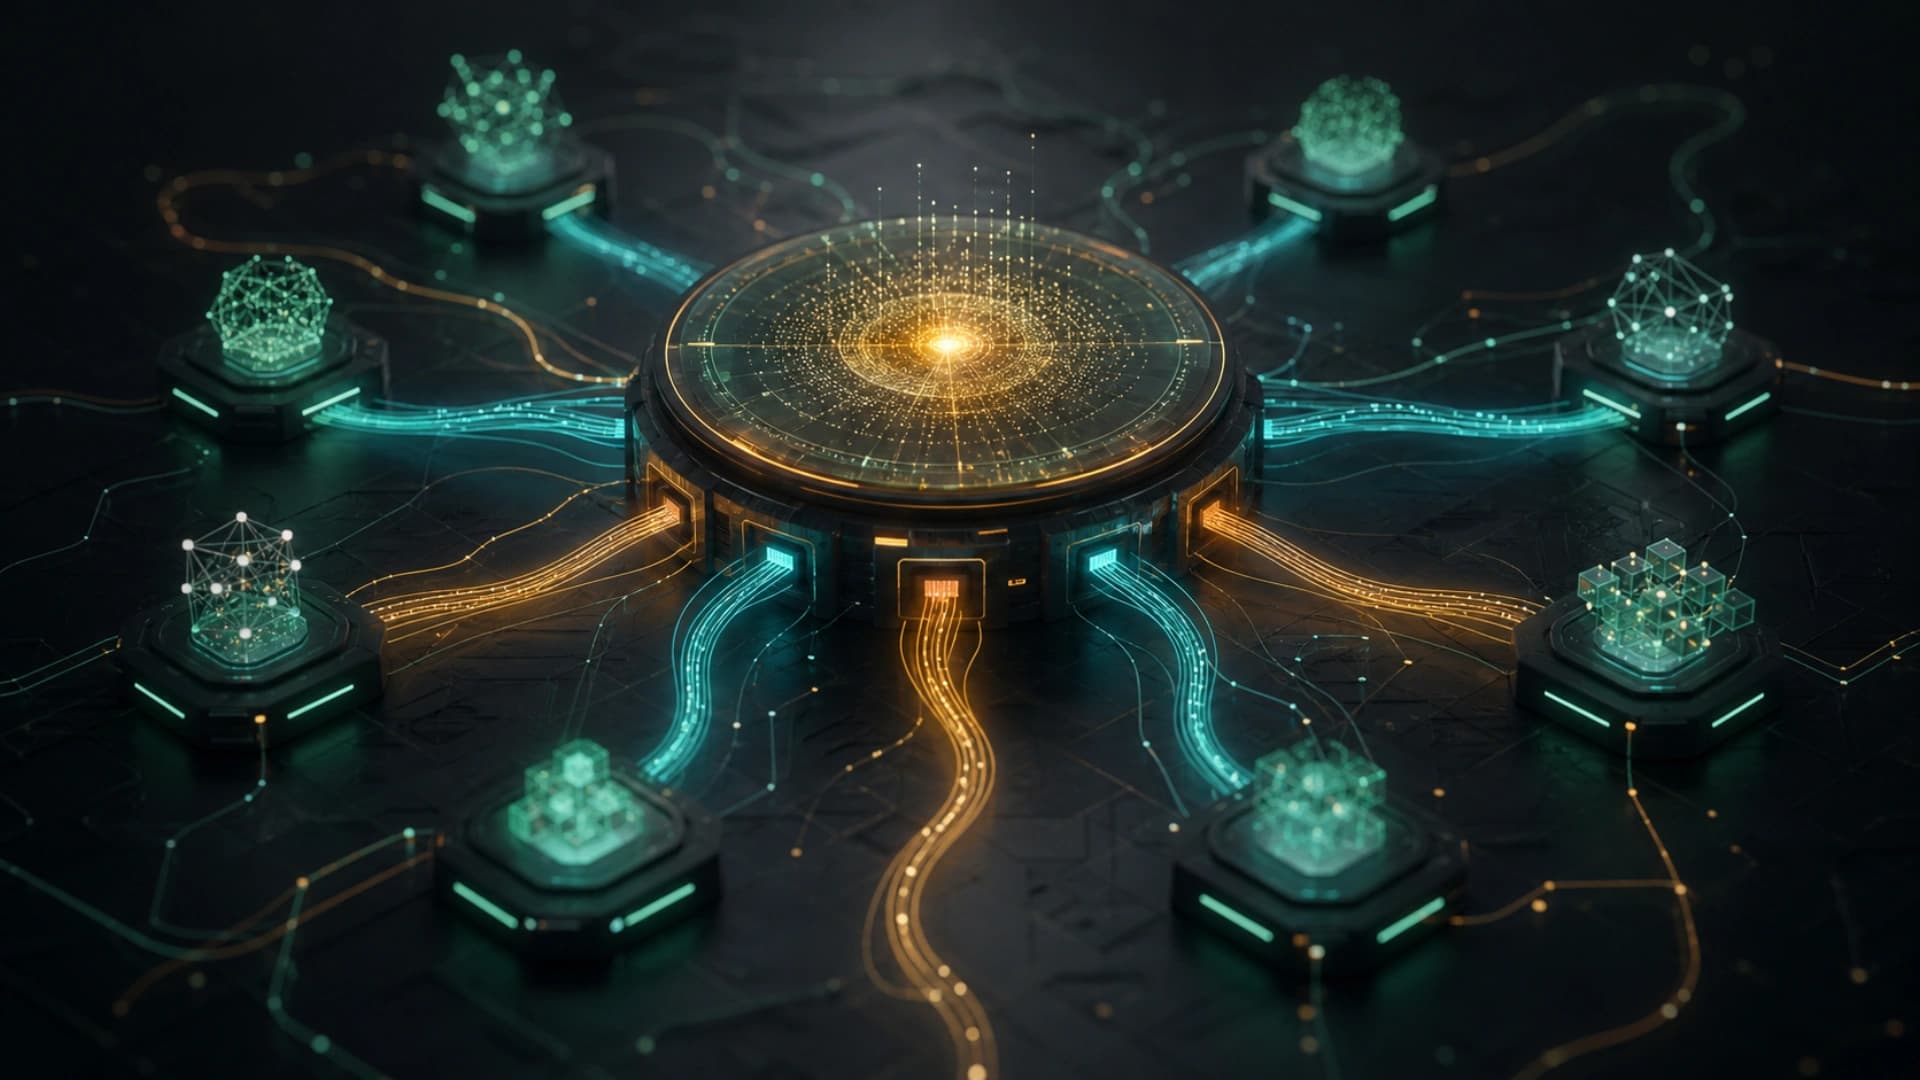
NeMo Switchyard 则是一个面向常用 agent 工具的开源 smart model routing library。它可以把请求路由到开放模型、专有模型或 NVIDIA 模型,并按照质量、延迟和成本调节路由策略。如果路由层与应用程序解耦,团队就可以逐步加入更快的专门模型,而不必为每次模型切换重写整个 agent workflow。
NVIDIA 自己的 benchmark 表示,Switchyard 在维持接近 frontier-level accuracy 的同时,把任务完成成本降至单独使用 Opus 4.8 的接近三分之一。这是供应商的内部测试说法,不能直接视为跨环境的成本保证。路由效果会受到 prompt、工具失败率、上下文长度、缓存、fallback 规则和各模型计费方式影响。
这次发布的实际信号,是 agent 架构开始把「模型选择」当作 runtime control plane,而不是一次性的 provider 设置。简单分类或高数量任务可以交给更快模型,只有需要复杂推理的步骤才升级到更昂贵模型。要让这种分工可管理,系统仍需要记录每次路由原因、模型版本、工具结果、成本和失败后的 fallback。
NVIDIA 表示 Nemotron 3.5 Lightning 可以部署在 RTX PC、DGX Spark、DGX Station、Jetson、RTX PRO、数据中心和云端等环境。这给本地、边缘和云端混合部署更多选择,但不会自动解决硬件驱动、量化、模型安全扫描、提示注入或数据泄露问题。把小模型放在更接近数据的位置,仍要配合最小权限和可审计的工具接口。
如果团队考虑采用,较稳妥的起点是先按成功率、延迟、成本和敏感度给任务分组,再为每组设置可回退的 routing policy。供应商 benchmark 可以作为候选信号,但 production gate 应由自己的 trace、固定回归集和人工抽查决定。