NVIDIA 于 2026 年 9 月 30 日分享一个以 NVIDIA NeMo 微调 Nemotron 3.5 ASR 的实验,目标是改善 Saudi Arabic 的 Najdi 和 Hijazi 方言识别。Nemotron 3.5 ASR 支持 40 个语言及 locale 的流式语音识别;这篇 Technical Blog 的重点则是如何利用有限的方言数据,减少模型在特定部署语境中的错误。
文章描述的流程包括基本数据整理、把目标方言数据与 FLEURS 混合的 weighted replay、按音频时长分桶,以及只解冻部分 encoder 层作微调。NVIDIA 表示,使用 133.7 小时 Najdi/Hijazi 数据后,目标测试分割的 word error rate(WER)由 55.05% 降至 29.96%;English WER 则由 11.04% 变为 10.42%,其他 Arabic dialects 没有出现退化。这些数字是该教程实验的结果,不能直接视为所有数据集和产品环境都会得到的幅度。
微调配置之间有明显取舍。文章指出,解冻全部 24 个 encoder layers 得到最低错误率,但要训练约 230.4 百万个参数;冻结较多层可以降低计算量,却可能牺牲适应效果。weighted replay 的目的,是让模型学习新方言时仍然接触原有语言数据,减少过度偏向目标数据的风险,但它只能保护被纳入 replay 的分布,不能替代对实际用户、设备、噪声和专业词汇的评估。
对于流式场景,NVIDIA 也测试 lookahead 和 beam search。文中表示,使用 13 个 lookahead、beam-8 的 MALSD 配置,在不重新训练的情况下把 WER 再降低 2.71 个百分点,但批量转录的延迟约为 800 毫秒。这反映语音系统不是只追求离线准确率:实时客服、会议字幕和语音控制要在错误率、延迟、GPU 成本和用户体验之间取平衡。
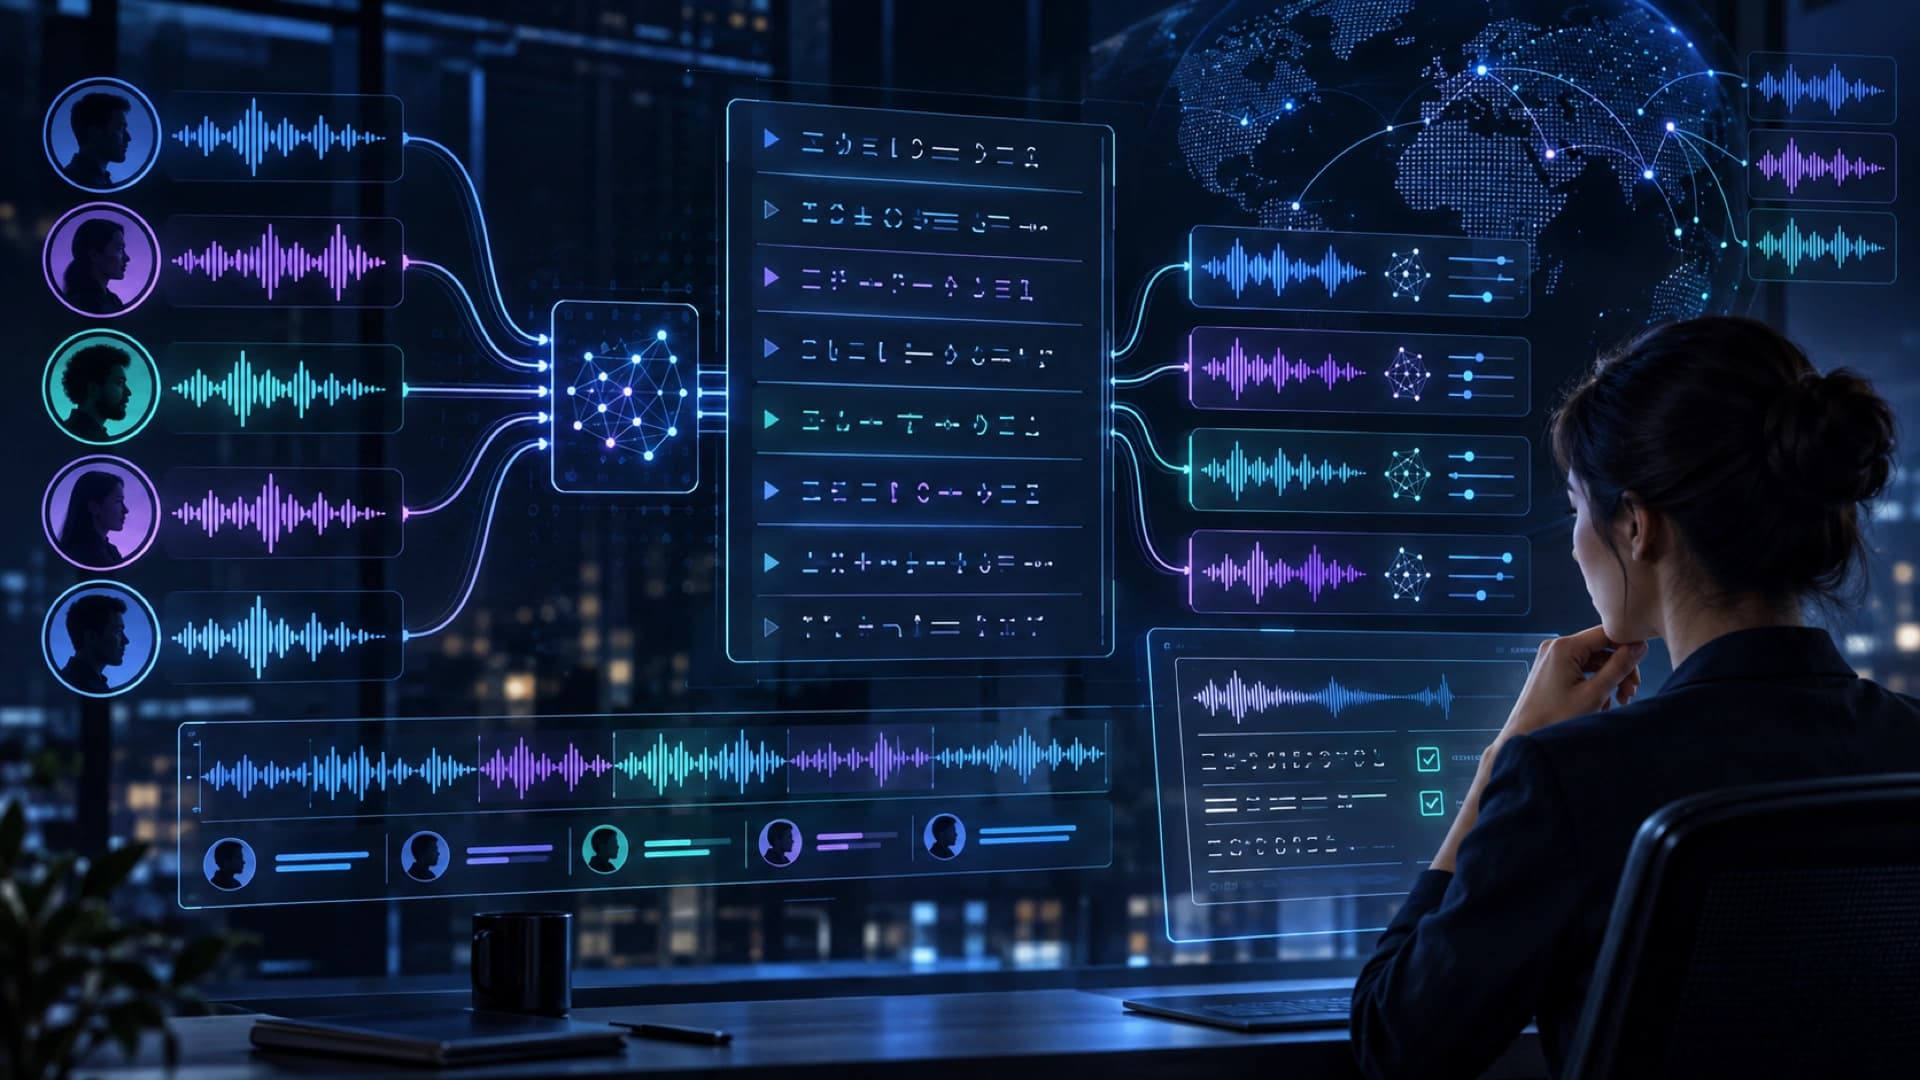
Nemotron 3 diarization 也被放在同一条部署路径中,最多支持 8 名说话者分离。对于多方通话或会议而言,分辨「谁在什么时间说了什么」可以让后续摘要、工单建立及合规审计更有用,但说话者分离错误会连锁影响文字内容和责任归属,所以仍需要在目标语言、口音和录音环境中独立测试。
这篇文章的实际价值,在于展示方言适配需要一条完整的评估链:先确认数据是否代表真实使用情境,再比较 replay、解冻层数和推理设置,最后同时衡量目标方言、其他语言、延迟和资源成本。NVIDIA 的结果提供一个可复现的起点,但它是供应商技术教程和实验报告,不应被解读成 Saudi Arabic 或其他语言部署的通用保证。