OpenAI 于 2026 年 9 月 10 日推出 Agents API 公开测试。它的核心不是再增加一个模型接口,而是把支撑 Codex 和 ChatGPT Work 的 agent harness 变成开发者可以调用的基础层。OpenAI 认为真正能完成长流程工作的 agent,需要同时处理上下文、工具、文件、执行环境和 subagent 协调,而不只是把一次模型回复包装成 API。
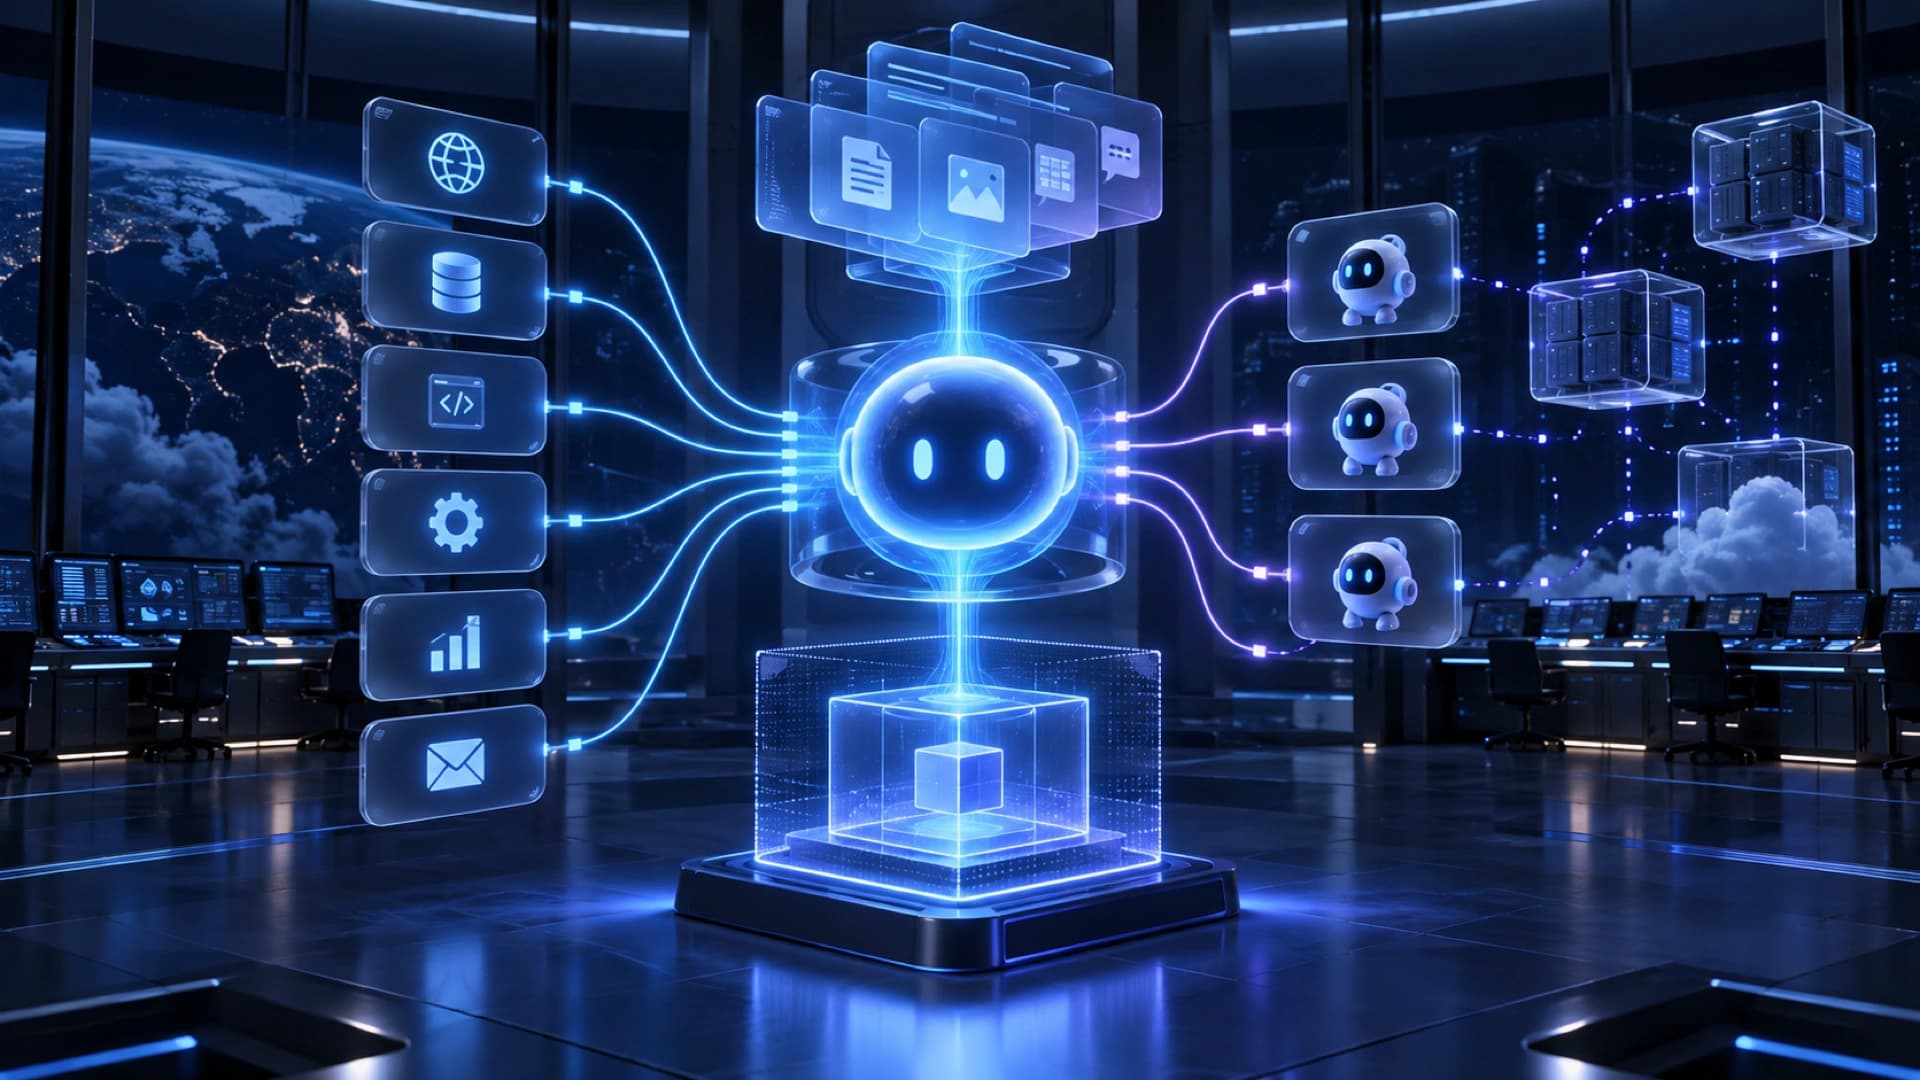
产品入口相当直接:开发者可以在一次 API 调用中指定任务、模型、工具和环境,建立一个 agent session。Agents API 支持 MCP、custom functions 和内置 web search,也可以连接 capability directories、文件、skills、plugins 和秘密存储。这种设计把 agent 的「思考」和「做事」放在同一个执行单元内,但哪些工具真正可用,仍由应用程序的权限及环境设置决定。
OpenAI 将 harness 与 compute environment 分开。用户可以选择 OpenAI 管理的 sandbox、自有基础设施,或者 Blaxel、Cloudflare、Daytona、DigitalOcean、E2B、Modal、Oracle、Runloop 和 Vercel 等合作环境。不同方案可以提供不同的 VPC、文件和 secret 存储、CPU、GPU、内存、cold start 和成本特性。这让企业不必因为采用一套 agent 协调方式,就把所有数据和执行权限搬到同一个供应商环境。
OpenAI 管理的 hosted sandbox 则面向希望快速开始的团队。它沿用 Codex 和 ChatGPT 的 sandbox 基础设施,让 agent 可以运行程序、处理文件和生成 artifacts。开发者可按任务提供 packages、skills 和 plugins;但「有 sandbox」不等于可以放任 agent 读写所有数据。正式部署仍需要按工作流拆分文件、网络、凭证和输出权限,并保留可恢复的执行边界。
长流程能力是另一个重点。Agents API 会在 session 接近上下文上限时自动 compact 旧内容,让工作跨越多个 context windows;tool search 只在需要时加载相关工具定义,以减少不必要的 token 和成本;programmatic tool calling 则可以并行执行调用、串接操作,并先在程序层过滤结果,再把有用部分带回模型上下文。这些都是 agent runtime 的工程问题,不是单靠更换模型就会自动消失。
多代理协作也被纳入 harness。Agents API 可以把复杂任务拆成独立部分,由各自保留上下文的 subagents 并行执行,再由主 agent 协调结果。对研究、分析和 coding 来说,这有机会缩短等待时间;同时也带来更多成本、重复工作、权限传递和结果合并问题。企业应该先为每个 subagent 定义输入、输出、工具和停止条件,而不是只设置一个很高的并行数字。
OpenAI 表示 Agents API 在公开测试阶段对所有开发者开放,除了模型和工具的正常用量外没有额外 API 费用。文章列出的客户例子包括评估、案件审查、物流和跨工具工作流,但这些是产品方提供的早期案例,不是独立重现的成效研究。开发团队在采用前,仍要用自己的任务衡量成功率、人工介入、延迟、token、重试、sandbox 成本和数据外泄风险。
这次发布的真正变化,是 agent 产品竞争开始由「哪个模型回答最好」转向「谁提供更完整、可升级、可观察的执行层」。OpenAI 以开源 Codex harness 加上托管 runtime,缩短了从原型走向长时间工作的距离;但企业仍要自行定义权限、审批、日志、回滚和责任边界。Agents API 让建立 agent 变得更容易,也让这些治理决定更早成为架构的一部分。