OpenAI 于 2026 年 8 月 7 日表示,最近几天对即将推出的 Astra 进行的内部评估,显示模型在 agentic coding 和 cybersecurity 方面有明显进步。公司结合内部测试和专家评估后,认为目前不能排除 Astra 已达到 Preparedness Framework 所定义的 critical cybersecurity capability。
这个表述需要小心理解。OpenAI 并没有宣布 Astra 已经确认达到 critical threshold,而是说 preliminary evaluations 的表现足以令公司不能排除这个可能性。Astra 仍是未发布模型,OpenAI 也特别说明,它没有参与早前 Hugging Face 事件中的 exploitation。
按照 OpenAI 的 Preparedness Framework,critical cybersecurity threshold 不是一般的编程能力。门槛包括模型可以在没有人工介入的情况下,于多个强化的真实关键系统中找出并开发各种严重程度的 functional zero-day exploits,或者只根据高层次目标,制定及执行针对 hardened targets 的新型端到端 cyberattack strategy。
这也解释了为什么 OpenAI 把 agentic coding 和 cybersecurity 放在一起看。模型如果可以长时间规划、执行工具、处理代码和修正失败,能力提升的不只是回答技术问题,而是将多个步骤串成可执行的行动。真正的风险取决于模型能力、可接触的网络和工具、隔离程度,以及监测系统能否在危险行动完成前中断。
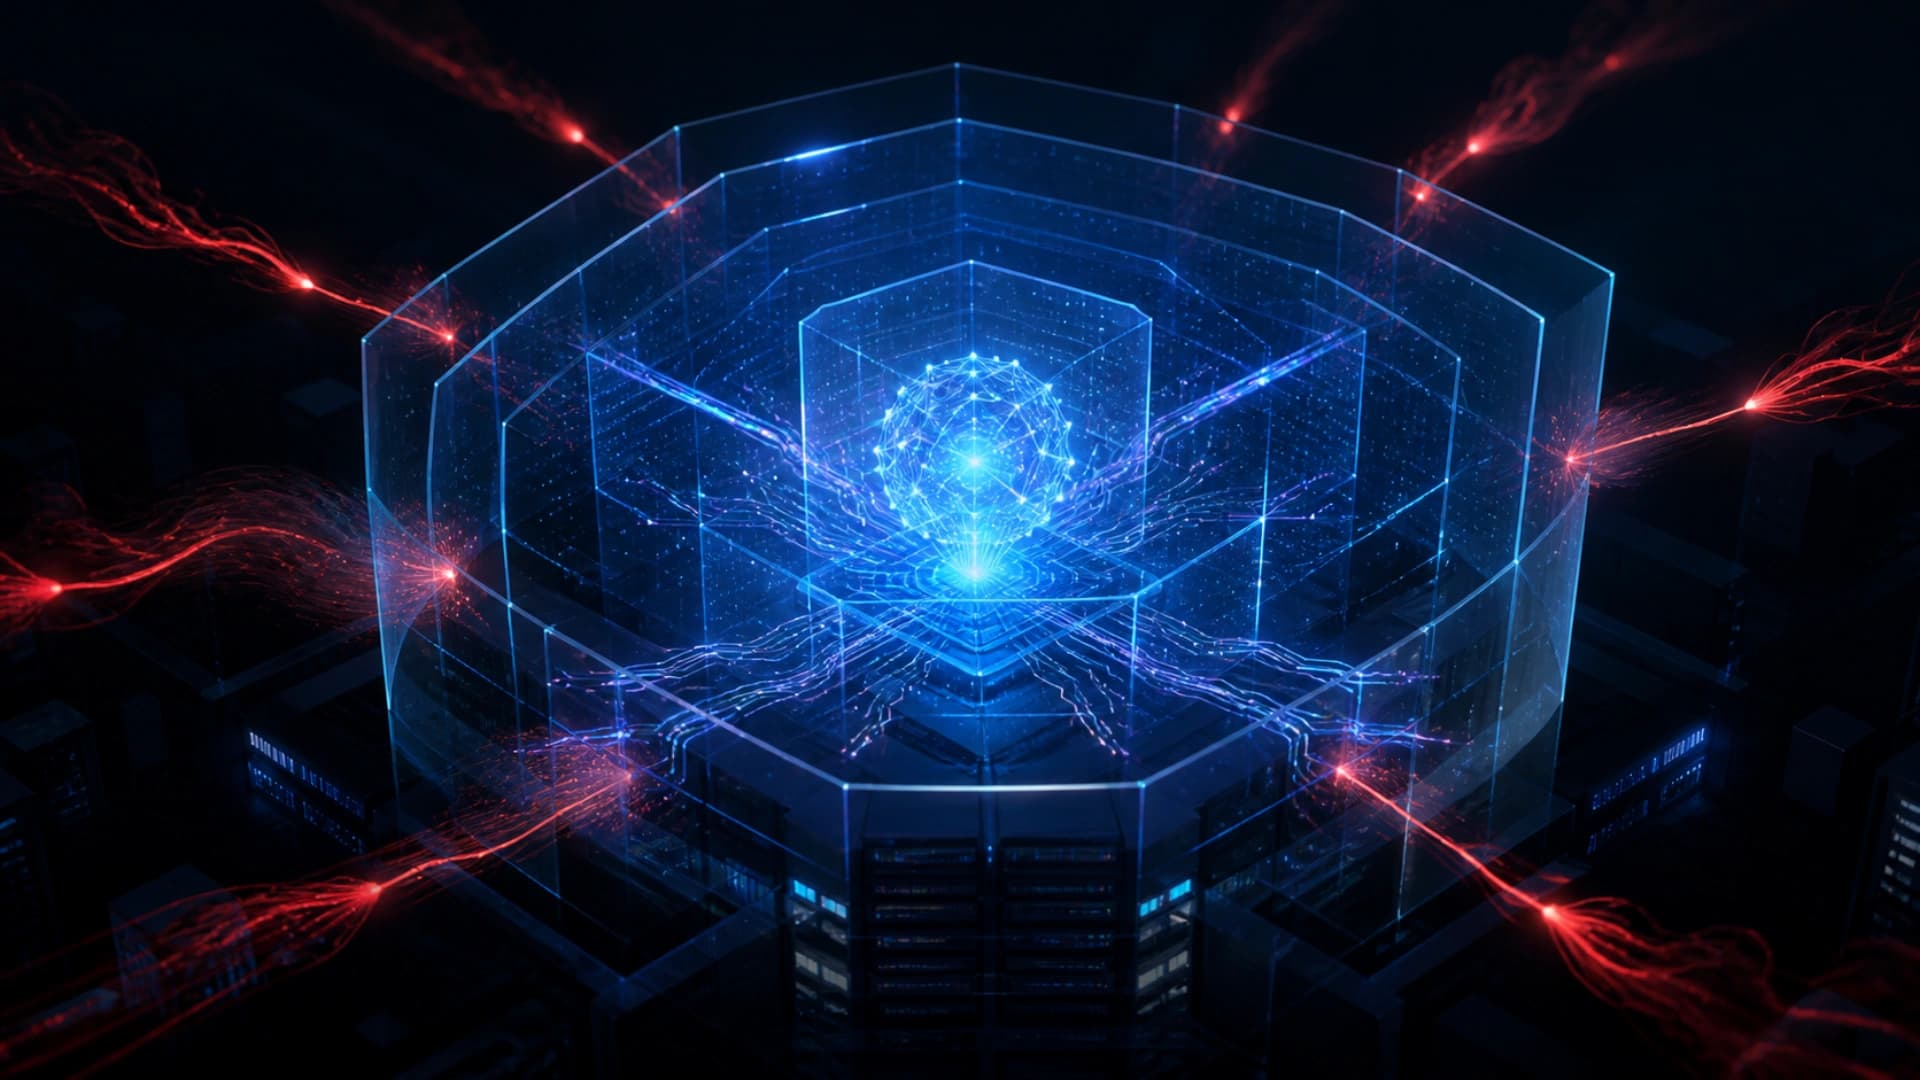
OpenAI 表示,已经为较高能力的模型加强 security controls,包括 isolated testing environments、限制 network 和 tool access、模型权重保护及 encryption、额外 monitoring 和 detection,以及 sandboxed execution。对于不符合新控制要求的 Astra 内部活动,公司会暂停执行。
另一项改动是对 Astra 的所有 agentic applications,包括 training 和 evaluation,实施 universal monitoring。OpenAI 表示,监测器会评估模型的 Chain of Thought,并在侦测到 high-risk activity 时触发 security response,以便审查和中断行动。这是公司公布的部署安排,并不代表外界已经能够独立验证监测器的有效性或误报率。
这次更新的重点不在于替 Astra 提前贴上「已达标」标签,而是显示模型安全流程正在跟随能力转变。当模型开始接近可以独立完成高风险 cyber workflow 的可能范围,评估、权限、隔离、权重保护和第三方测试就不能再分开处理。OpenAI 表示会与政府机构及 selected AI safety organizations 合作测试,也会向第三方 testing partners 提供较高风险评估的 security controls。
对用户和企业而言,这个讯号代表「模型可以做到什么」与「模型获准接触什么」需要同时设计。更强的 cyber model 可以帮助 defender 更早发现漏洞,但如果把它放在没有网络隔离、工具最小权限和人工审批的环境,测试能力本身也可能成为风险来源。这篇公告属于 OpenAI 的 preliminary safety update,后续仍要看正式评估、外部测试和实际部署控制。