OpenAI 在 2026 年 6 月 25 日发布一篇新的 Economic Research 文章,主题是 agents 如何改变工作。这次焦点不是再介绍一个功能,而是用 Codex 作为样本,研究 AI agent 在前沿知识工作里可以承担多少经济价值。对企业来说,这比一般产品更新更重要,因为它把 agent 从 demo 拉回到工作量、任务时间和人类审核的现实问题。
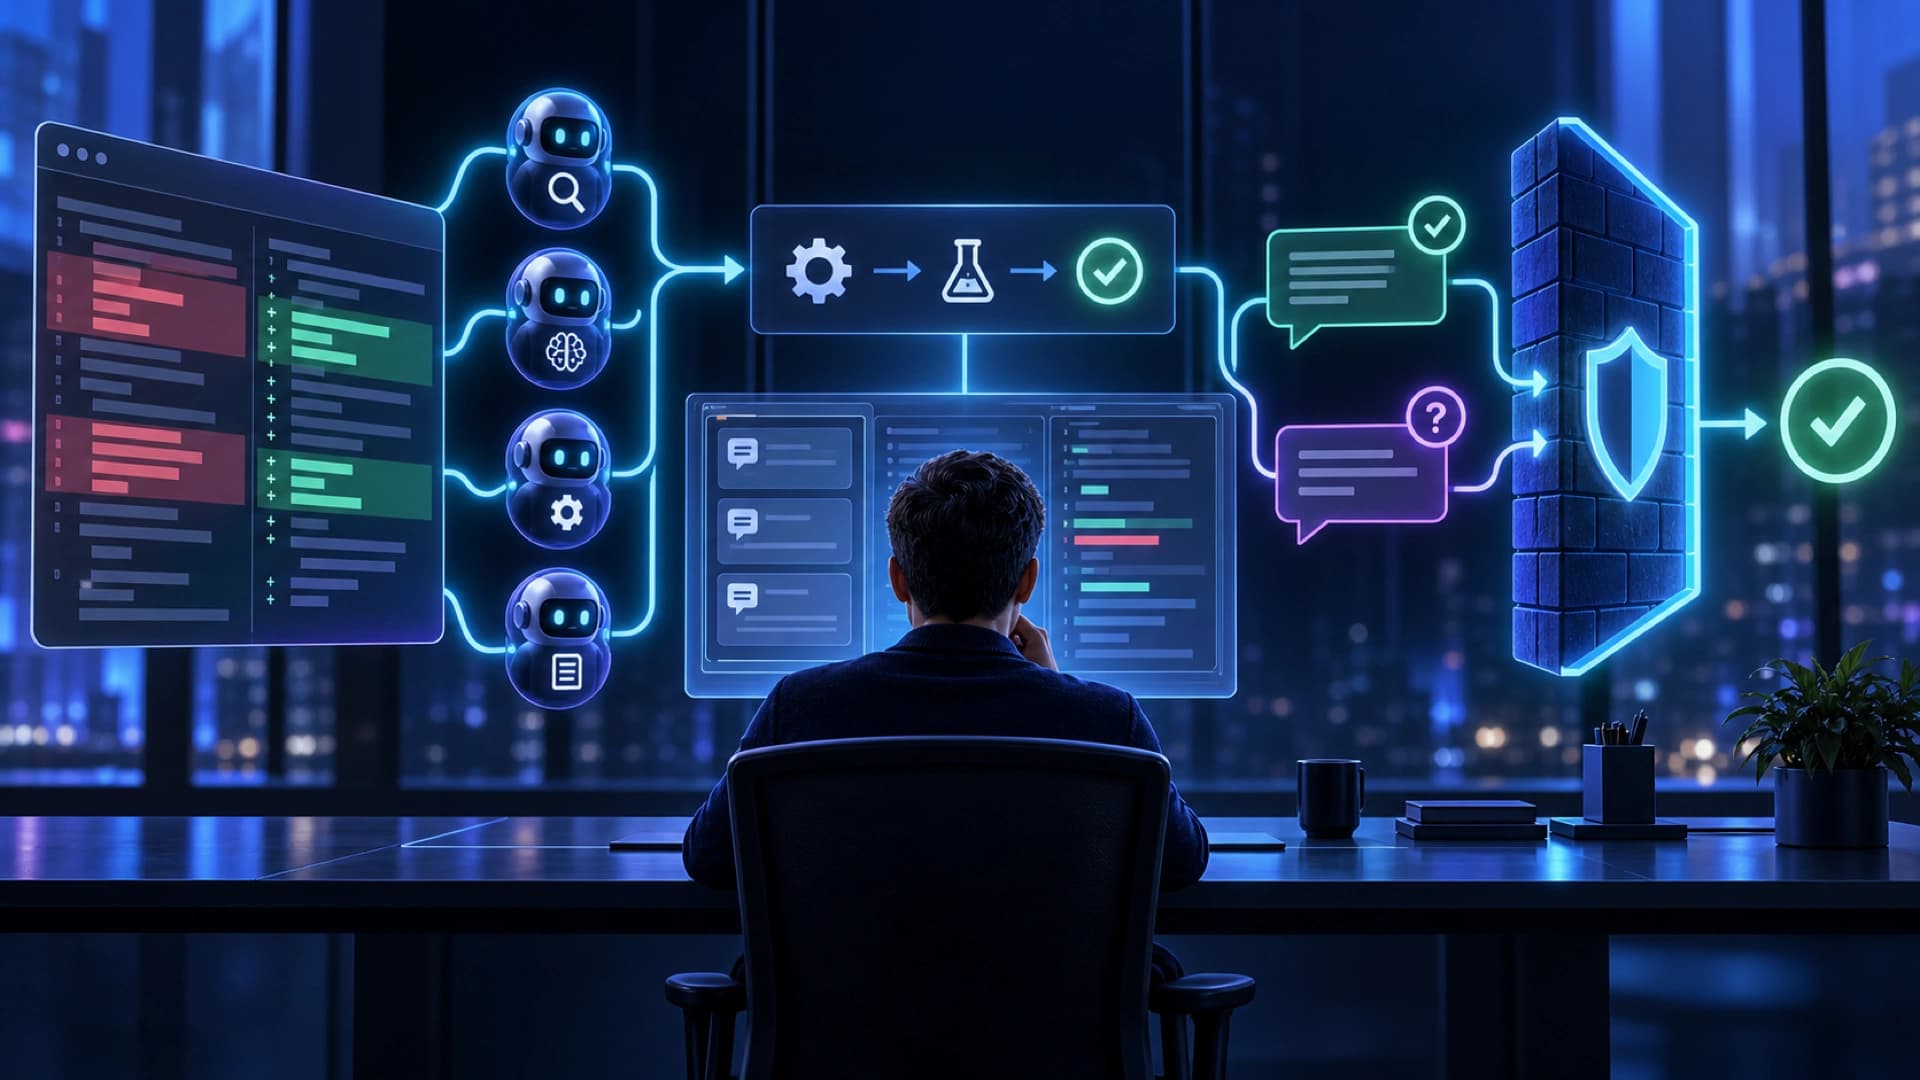
文章的核心讯号,是 Codex 这类 agent 开始处理较长时间、较复杂、需要多步骤推理和执行的任务。过去 chatbot 主要回答问题或产生文字,价值很大但多数仍停留在即时互动。Agent 的分别在于可以接收一段较完整的工作,自己展开、调用工具、产生结果,再交给人检查。
OpenAI 把这个方向称为量度 Codex 在 frontier economic potential 上的能力。这种量度方式很有意思,因为它不只问「模型答得准不准」,而是问一个任务如果由有经验的人做,需要多少时间、多少判断、多少上下文。当 AI agent 能处理这类任务,企业采用 AI 的评估方法就会由 seat count 转向 delegated work volume。
对工作流程的启示很直接。Agent 不是要把每个职位立即自动化,而是先吃掉那些可以清楚描述、可验收、可回滚的工作片段。代码修改、资料整理、法务初稿、财务核对、客户问题分类、内部知识搜索,都可能成为这类任务。人的角色则由每一步亲手执行,变成设定目标、提供约束、审阅结果和处理例外。
这亦解释了为什么 2026 年的 AI competition 会集中在 agent tooling,而不只是模型榜单。要让 agent 真的进入工作,系统需要档案、repo、数据库、浏览器、工作票、审批、记忆和权限控制。没有这些上下文和治理,agent 只能在沙盒里示范;有了它们,agent 才可能变成可衡量的工作单元。
值得留意的是,OpenAI 选择用 Codex 做这类研究,也反映 coding agent 仍然是最容易量化的早期市场。软件任务有清楚输入、可测试输出、版本控制和 review 流程,所以特别适合先验证 agent work。当这套方法成熟后,同样的量度框架会逐步外溢到营运、财务、销售和合规。
这篇文章的最大启示,是企业不应只问 AI 能不能「帮手」。更实际的问题是:哪些任务可以被拆成 agent 可接收的工作包?哪些输出可以用测试、审批或人工 review 验收?哪些资料和权限要先整理?当答案变清楚,AI agent 才会由聊天工具变成真正的工作基础设施。