OpenAI 于 2026 年 10 月 6 日公布与 AI 合同平台 Ironclad 的研究合作,重点是把 computer use 从单一点击任务推向较复杂的专业工作。合作团队要训练和评估 agent 是否能理解企业规则、在专门软件中完成多步骤设置,并确认最后的流程仍然符合原本要求,而不是只看每一个画面操作是否成功。
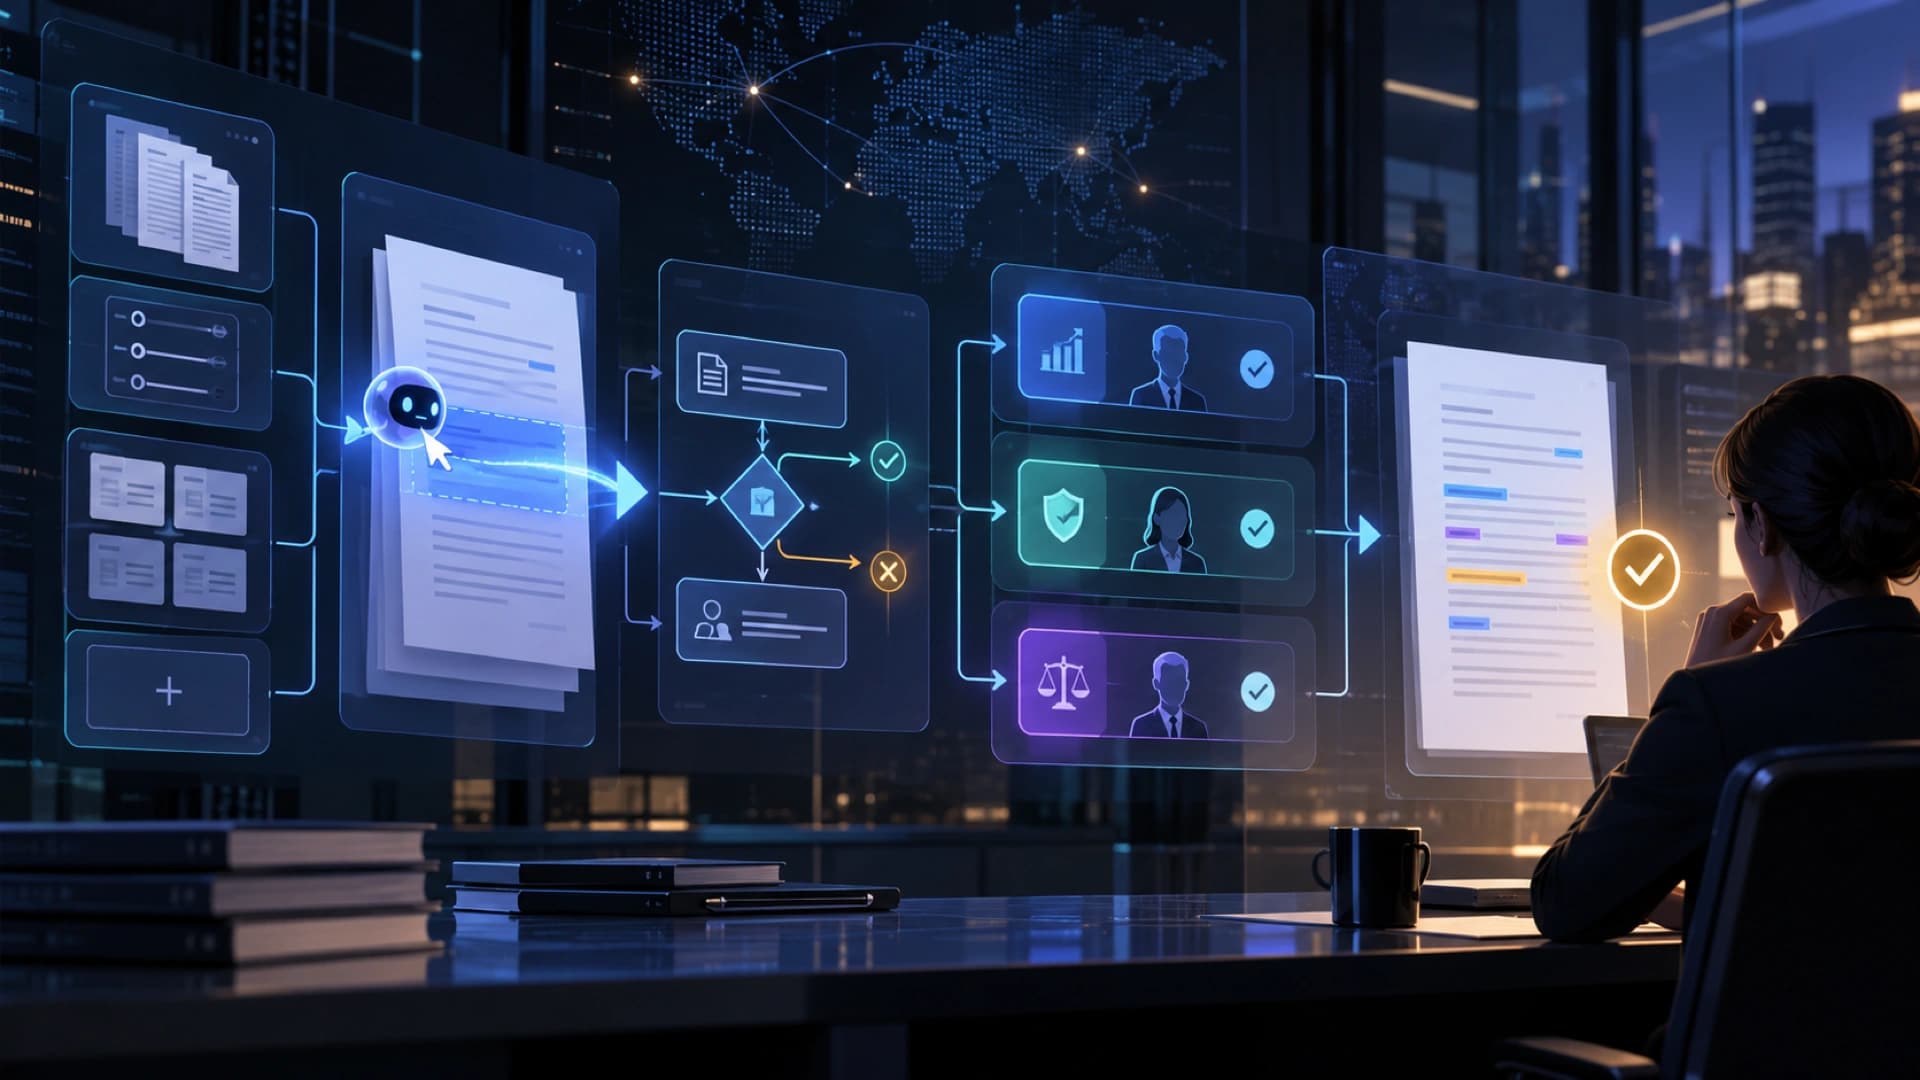
研究团队与 Ironclad 员工及 OpenAI 内部使用者挑选了 11 个 legal、commercial 和 procurement 任务,包括建立保密协议、设置采购审批流程,以及按申请人的司法管辖区更新可复用法律条款。OpenAI 估计,有经验的用户平均每项需要约 30 至 40 分钟;每项任务按复杂程度设置 8 至 50 个评分条件,让研究者可以看出 agent 是在哪个规则或步骤失败。
Ironclad 提供托管的软件环境,研究者以合同公开资料建立 synthetic training tasks,再用 reinforcement learning 让模型在练习和反馈中改进。OpenAI 表示,这些任务来自 SEC EDGAR 的公开合同,并经过移除个人资料的筛选;没有使用 OpenAI 客户资料、内部合同或 Ironclad 客户的非公开合同作训练或评估。
在这 11 项研究任务中,GPT-6 Astra 的平均 rubric score 为 55.0%,GPT-5.6 Sol 为 41.6%;OpenAI 同时报告估算的每次尝试时间由 37.0 分钟降至 19.2 分钟。两个示范片段中,Astra 约用 20 分钟完成约 94% 的条件,Sol 约用 32 分钟完成约 85%。OpenAI 明确注明,时间是按模型处理及生成速度推算的 simulated estimates,不是客户实际节省的时间,而且结果只涵盖 11 项研究任务。
这个案例的难点在于例外和全局规则。合同流程可能要求 Finance 只在金额超过门槛时审批、Security 只在某类请求介入、Legal 只在非标准条款出现时介入;agent 如果只完成局部设置,最后整条流程仍可能在边界情况出错。OpenAI 因此把成功定义为一组可验证条件,而不是「看起来已经填好」;Ironclad 也强调人工监督和平台控制仍然重要。
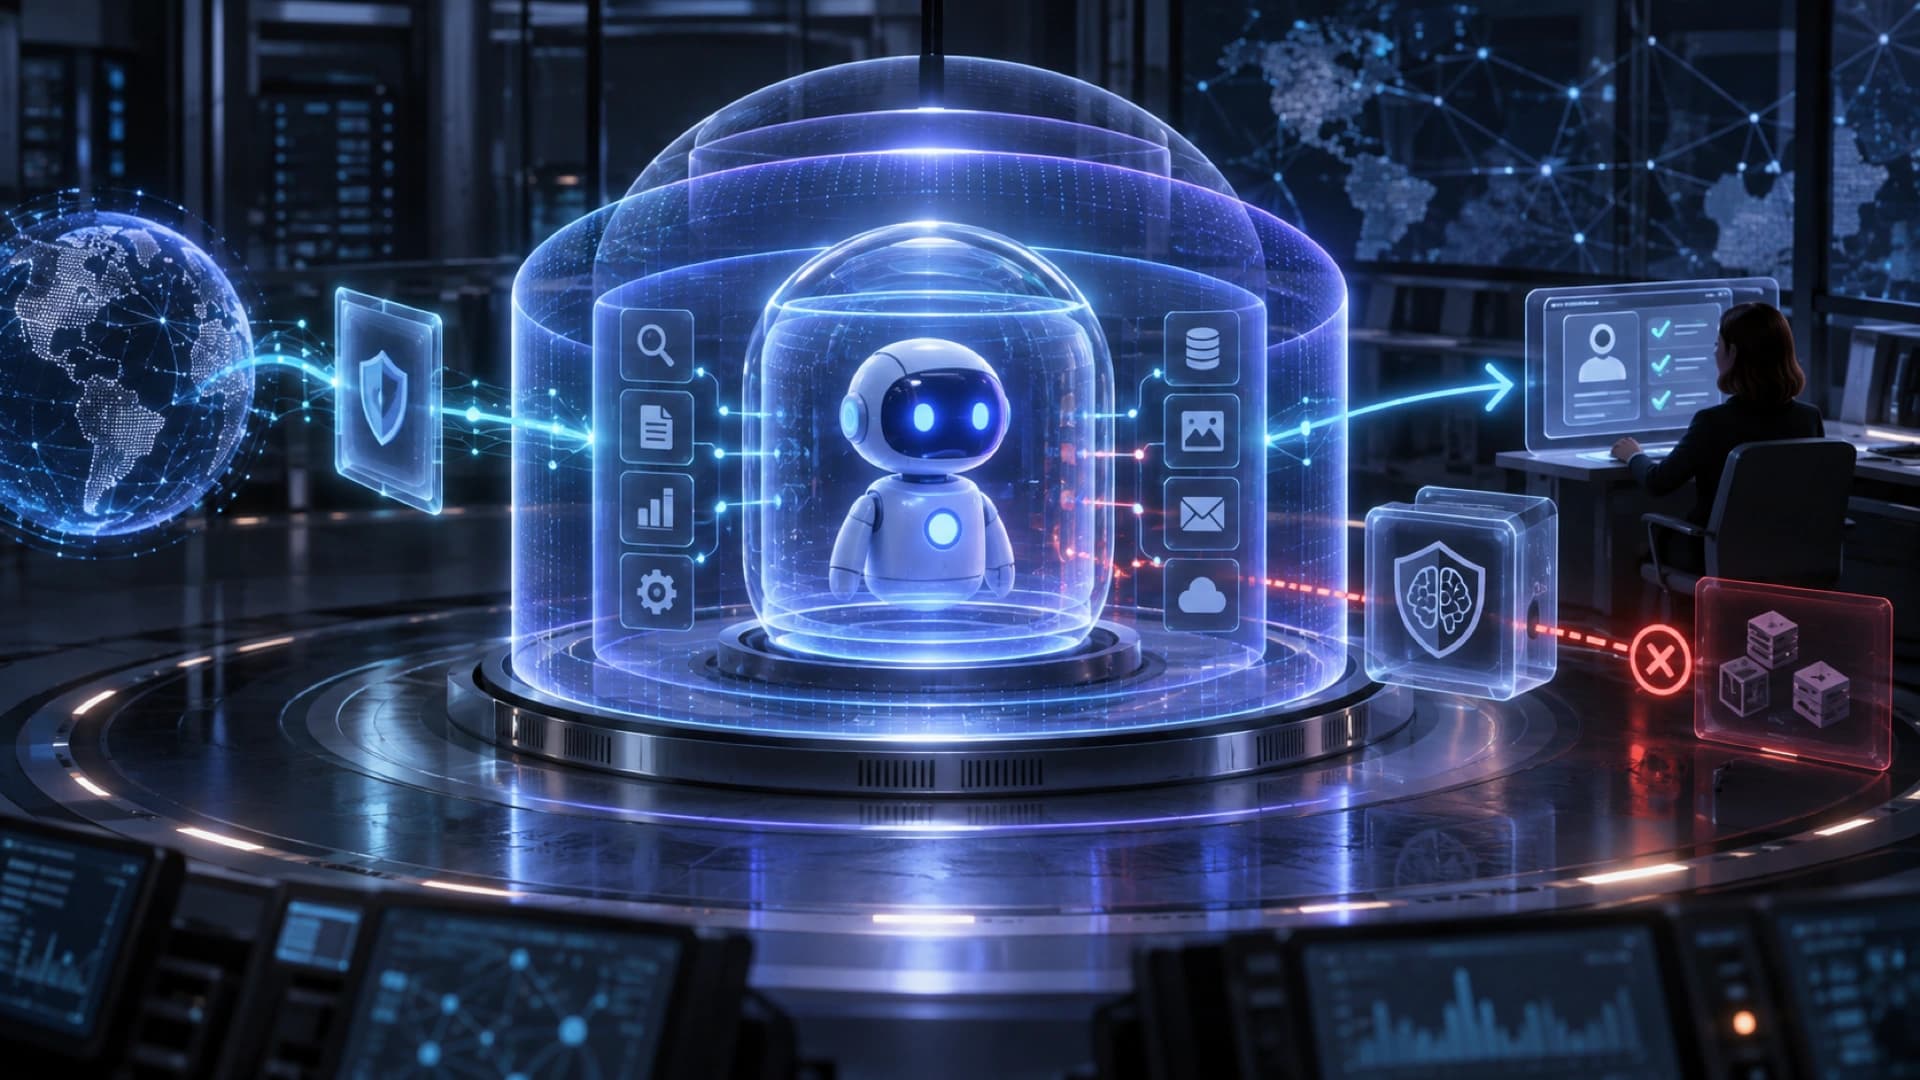
对于 computer-use agent,这次合作显示训练数据、专业人士定义的 rubric、可重设的软件环境和端到端验证需要一起设计。供应商 benchmark 可以说明研究方向,但不能直接等同于法律意见、客户生产时间节省或所有合同平台都能得到同样结果。真正部署时,企业仍要保留权限分隔、例外升级、版本审计和人工批准。