一篇於 2026 年 8 月 7 日提交到 arXiv、並標示為獲 ASE 2026 接受的研究提出 AgentChaos,將 chaos engineering 的故障注入方法應用到 agent systems。研究的重點不是比較哪個 LLM 的答案最好,而是在 runtime 期間有系統地破壞 agent workflow 的不同部分,再觀察系統能否感知和處理故障。
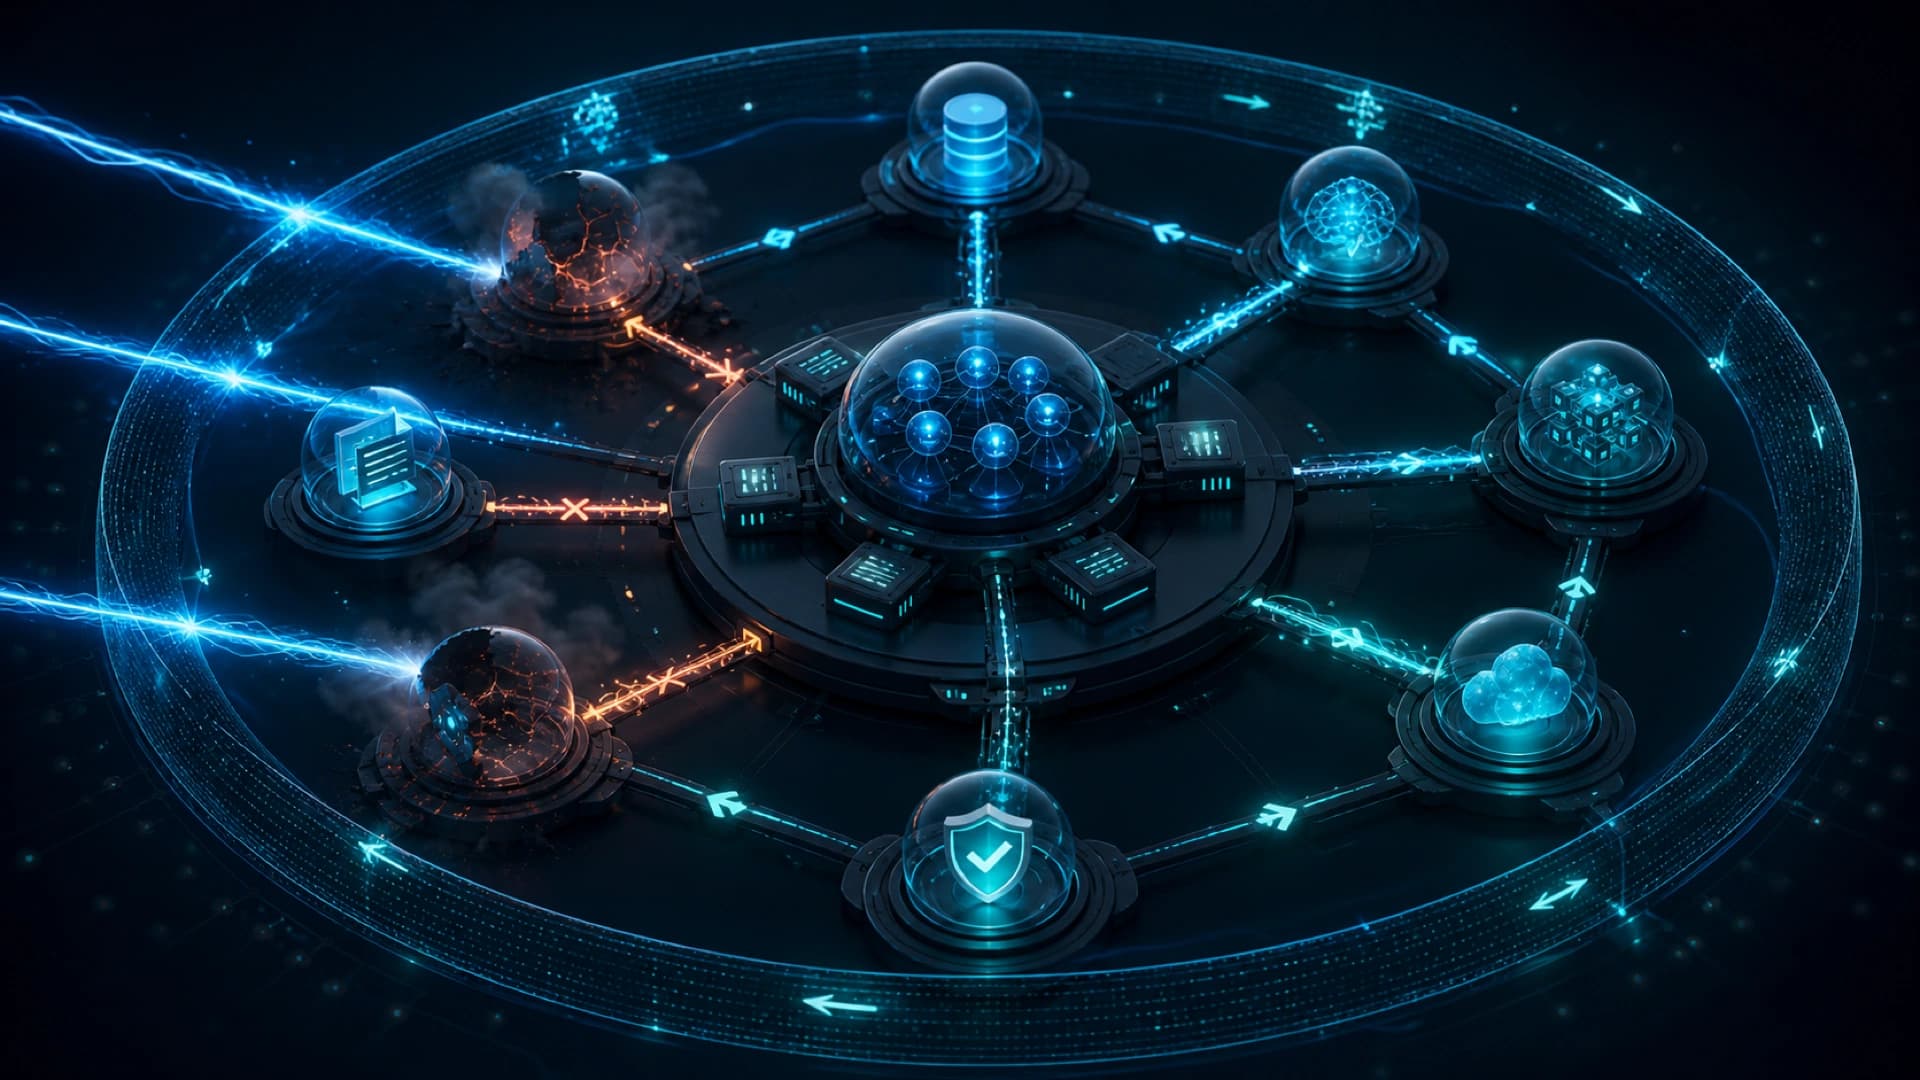
AgentChaos 在共用的 HTTP layer 做非侵入式 fault injection,因此不需要重寫每個 agent framework。研究描述的 fault types 包括 crash、omission 和 value faults,目標欄位可以是訊息內容或 tool-call 欄位。系統同時驗證 fault 是否真的被觸發,避免測試看似執行了,實際上沒有改變被測流程。
這種測試方式很接近 production agent 的真實失敗形態。agent 可能收到格式正確但內容錯誤的工具回應、遺失一個必要事件、在中途崩潰,或者把一個不安全的參數傳給下游服務。若只測試模型在正常輸入下的 pass@1,就很難知道 orchestrator、retry、timeout、state recovery 和人手升級是否真的有效。
論文在 65 個 configurations 上報告,故障注入可以令部分系統的 pass@1 下降最多 50 個百分點。作者亦指出,不同模型的結果排名相當一致,表示 agent robustness 可能更多取決於系統實作,而不只是底層模型。這些結果屬於研究者在其 benchmark 和配置下的報告,不能直接當成所有 production agent 的故障率。
AgentChaos 帶來的工程啟示,是 agent reliability 需要把「模型出錯」和「系統處理錯誤的能力」分開驗證。測試計劃可以把工具錯誤、空回應、延遲、重複事件、錯誤格式和權限拒絕列成 fault matrix,再檢查每種故障是否有清楚的 timeout、重試上限、冪等處理、告警和人工接管。
故障注入也要有安全邊界。測試流量應在隔離環境運行,所有注入要有 trace id 和可回放記錄,並避免把破壞性 fault 傳到真正的 production 資料。對有租戶和敏感資料的系統,fault harness 本身也要遵守最小權限和資料脫敏。
如果 agent workflow 會自動修改程式碼、發送訊息或呼叫外部交易服務,故障測試尤其重要。理想結果不是「任何 fault 都不會令任務失敗」,而是系統能在失敗時停止在可接受的狀態,向使用者說明原因,並且不會重複執行不可逆的副作用。
AgentChaos 將 agent 測試由靜態 benchmark 推向 runtime resilience。當 agent 逐漸接入更多工具和長流程,能否在受控故障下被觀察、診斷和復原,會和模型本身的推理能力一樣影響可用性。