Anthropic 於 2026 年 10 月 1 日刊出物理學家 Matthew Schwartz 的客席文章,提出「Claude-shaped problems」這個概念:不是先要求模型模仿人類科學家的全部工作,而是找出現時的大型語言模型特別擅長、又能被檢查的問題。Schwartz 以這個方向建立 BootLoops,一套用於定量科學精確計算的開源工具及協議。
文章先指出一個現實限制:Claude 和 GPT 可以處理大量知識、程式碼、數學、統計、論文及數據,但不等於已經具備人類科學家的概念判斷。Schwartz 把這種落差形容為 impedance mismatch。BootLoops 的做法是把模型放進一個更適合它的 harness,讓它重用工具、執行計算、產生可驗證的結果,再由人類研究者判斷問題是否真的有科學價值。
最初的工作集中在 scattering amplitudes 和半數值 bootstrap。文章表示,Claude 把不同論文和程式碼整理到共同框架,端到端完成 30 個 integrals,其中 15 個重現已知結果、15 個以前未計算過。這些數字來自文章的研究敘述;它們顯示工具和 agent 協作的產能,不代表每個新結果都已經獲得學界獨立確認。
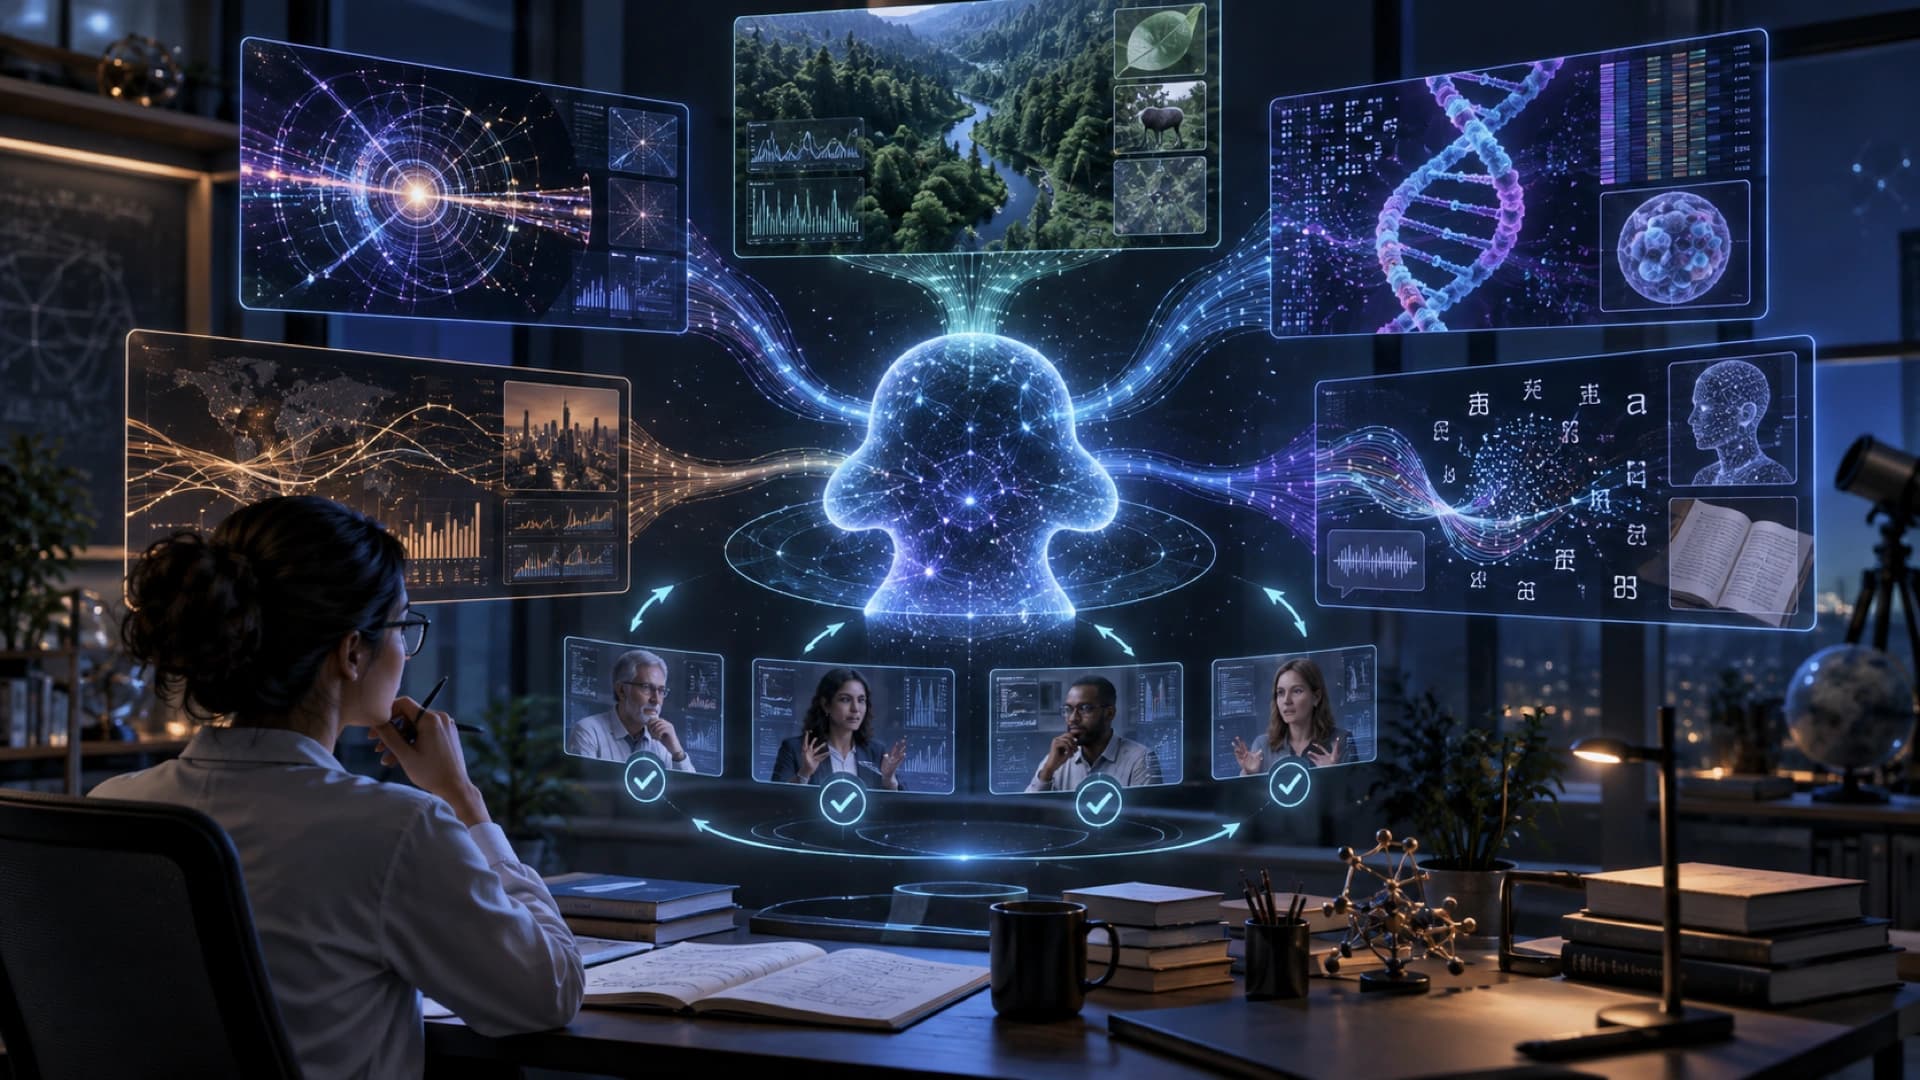
BootLoops 之後被帶到 ecology、population genetics、economics 和 linguistics。文章提到,Claude 在森林中性理論、基因變異、論文 replication package 和語言重音資料等方向找到技術上可行的連接,但技術正確不等於科學上重要。Schwartz 需要邀請不同領域專家,把模型找到的計算轉成真正值得研究的問題;有些初步結果最後被專家認為不夠有趣,亦有些經過共同修改後才變得有意義。
這種 workflow 需要不少編排。Schwartz 描述他把多個 Claude Code session 放在 Google Cloud VM 上,分別處理計算、寫作、工具建立和 adversarial review,再由 master session 協調資源及驗證結果;中間產物會存成 Markdown 檔案。即使有 harness,模型仍會誤判完成、低估時間、反覆 grind,或在長任務中失去上下文,所以研究者要設定嚴格成功條件、查看圖表及追問結論。
文章亦披露 BootLoops 不是 Anthropic 項目,而是 Schwartz 擁有及維護的工具;他在研究期間擔任 Anthropic visiting researcher。較穩妥的解讀是,這是一個由科學家分享的早期案例:AI 的價值可能首先出現在「工具、計算、跨領域搜尋和專家判斷」組成的可驗證迴圈,而不是一個 prompt 直接取代科學方法。