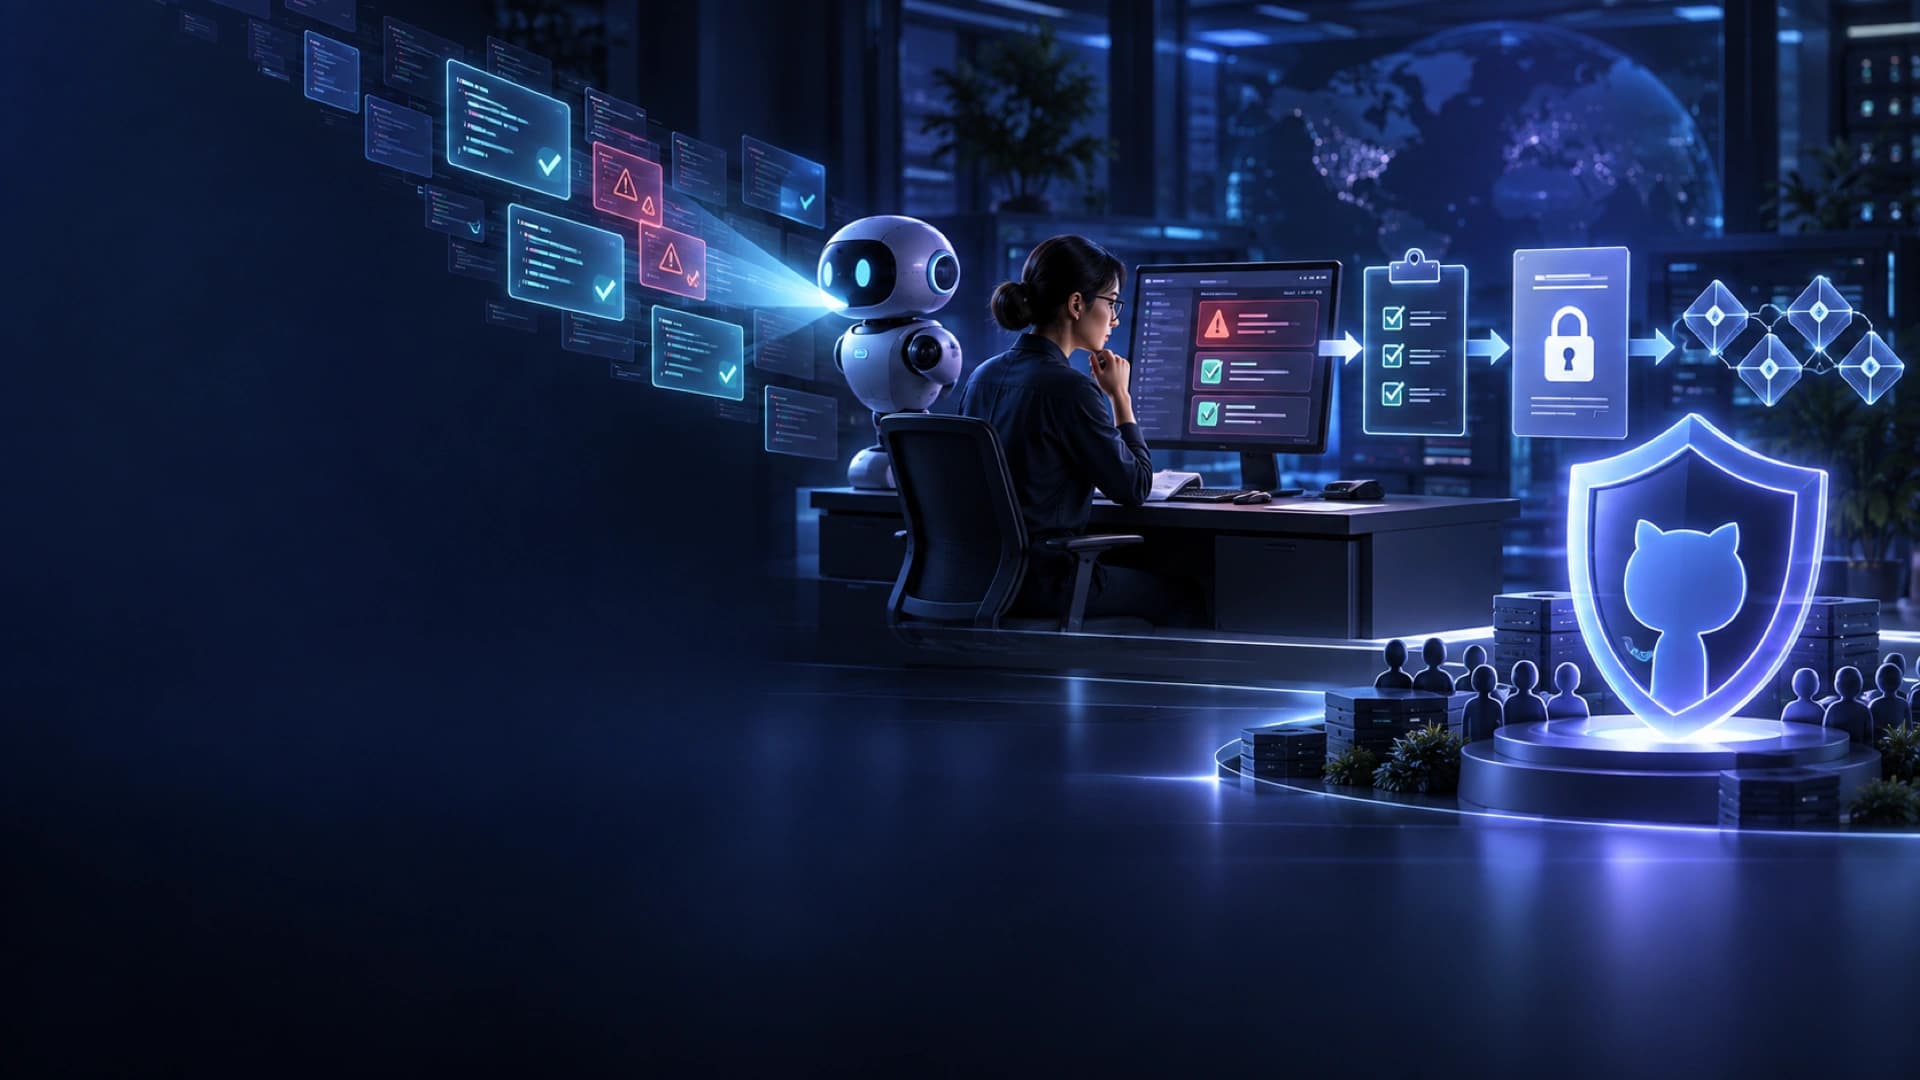
Anthropic 於 2026 年 10 月 2 日更新 coordinated vulnerability disclosure 儀表板,說明 Claude 模型如何協助尋找開源軟件漏洞,以及為甚麼模型找到問題不等於問題已經可以公開。Anthropic 表示,研究流程會使用包括早期 Mythos Preview snapshot 在內的 Claude 模型,再由外部網絡安全研究機構進行分類、重現和驗證,最後由人員審閱後才向維護者和公眾披露。
按 Anthropic 儀表板的當日快照,合共列出 6,157 個已披露漏洞,涉及 591 個開源項目;其中 516 個已修補,並有 584 個 CVE 或 GHSA 識別碼。這些數字應視為 Anthropic 對其計劃的報告,不是獨立審計或全開源生態的完整普查。儀表板也明確指出,公開數字只是模型或研究流程找到的全部候選問題中的一部分,因為人手分類和維護者協調是瓶頸。
同一份資料還列出 29,439 個發現、6,123 個候選項目、5,674 個已審核項目,以及 92.7% 的 true-positive proxy。這個比率不是「模型準確率」的普遍結論,而是儀表板在指定供應商和審核流程下的指標。評估時要分清楚發現數、候選數、已核驗數和已披露數,否則很容易把研究流水線的中間數字當成實際可利用漏洞的數量。
Anthropic 將流程重點放在負責任披露和 provenance。研究者會先保留發現紀錄、建立雜湊承諾,再在適當時間把技術資料分階段交給維護者,讓開源項目有機會修補及準備公告。這種做法的價值,不只是把漏洞數字放到排行榜,而是把模型產生的候選訊號放入一個有人核驗、可追蹤、避免過早公開的安全流程。
這個案例也提醒人們,AI 輔助安全研究的限制不只在模型能力。模型可以擴大搜尋範圍,但高質量披露仍要依賴環境重現、影響判定、與維護者溝通、修補確認,以及避免把未驗證的技術細節變成濫用指南。Anthropic 的儀表板沒有在這篇更新中提供可直接操作的 exploit 教學;它展示的是治理指標和流程狀態。
對企業或開源維護者來說,較實用的啟示是把「AI 找到問題」和「安全團隊可以接受問題」設成兩個不同的階段。需要有候選去重、人工優先排序、受控重現、修補驗證、CVE/GHSA 追蹤和時間線記錄。若只把模型輸出直接交給公眾或自動化修補,反而可能增加誤報、供應鏈噪音或不必要的披露風險。