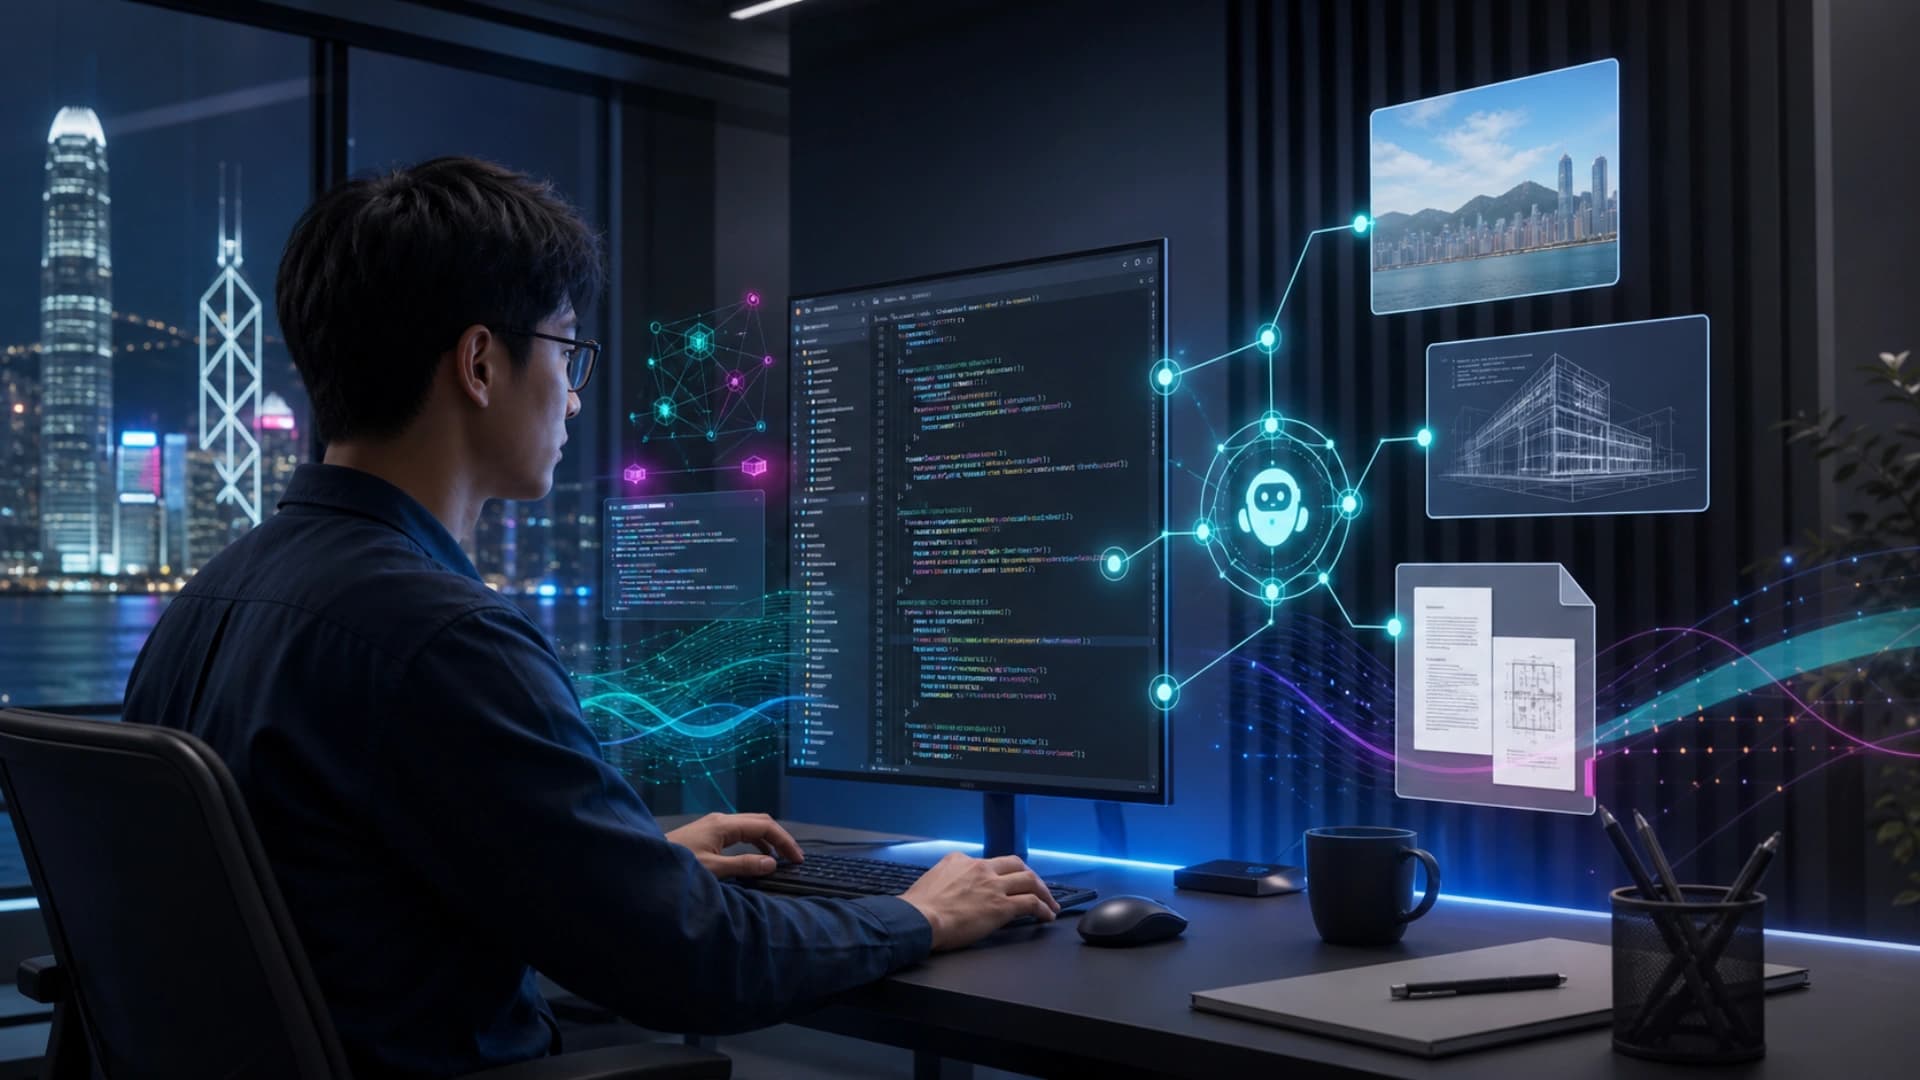
GitHub 在 2026 年 7 月 1 日宣布 Copilot Vision 正式可用。這個更新的重點,是開發者可以把圖片和 PDF 直接附加到 Copilot Chat prompt,讓 Copilot 在回答時同時理解視覺資料和 codebase 上下文。
這對前端、產品和設計交付很實際。很多工程任務不是只看程式碼就能判斷,例如設計稿、客戶截圖、錯誤畫面、PDF 規格、流程圖和報告附件。過去 developer 要先把畫面內容翻譯成文字,再要求 AI 修改程式;現在 Copilot 可以直接把視覺素材納入 reasoning loop。
GitHub 說明支援圖片和 PDF,並把功能帶到多個 Copilot plan。這代表 multimodal coding 不再只是 demo,而是開始變成日常開發工具。當 agent 可以看見 screenshot、讀到規格 PDF、再結合 repo 內容提出修改,很多「照圖改 UI」和「按文件補邏輯」的工作會更容易被委派。
對企業來說,這也會改變需求交付流程。產品、營銷或營運同事可以把視覺參考、報表或客戶提交的附件交給工程團隊,工程師再用 Copilot 將這些材料轉成具體修改。真正的價值不只是少打幾句 prompt,而是減少上下文轉譯和反覆澄清。
不過 multimodal agent 亦需要治理。圖片和 PDF 可能包含客戶資料、商業文件、截圖中的 token 或內部系統畫面。團隊要建立清晰規則:哪些檔案可以給 Copilot、哪些要先遮蔽、哪些任務仍要人工審查。
Copilot Vision GA 的訊號,是 AI coding 正由純文字輔助走向「看見工作材料」的階段。當 agent 能理解設計、文件和程式碼之間的關係,開發流程會更接近真實工作委派,而不是只是一問一答。