Google DeepMind 於 2026 年 9 月 23 日介紹 Private AI Compute 的伺服器端持久記憶架構。目標是讓 AI 助手可以在手機、電腦和智能眼鏡之間保留上下文,同時把部分原本只適合在裝置上處理的私隱保護方式帶到雲端計算環境。
Google 描述的設計是:需要長期保留的資料放在專用的加密儲存中,而解鎖資料所需的密碼匙只由使用者的個人裝置持有。官方聲稱,即使是 Google 也不能存取這些記憶。這是 Google 對其架構的描述和安全目標,不等於外部已證明所有實作和運作流程都沒有弱點。
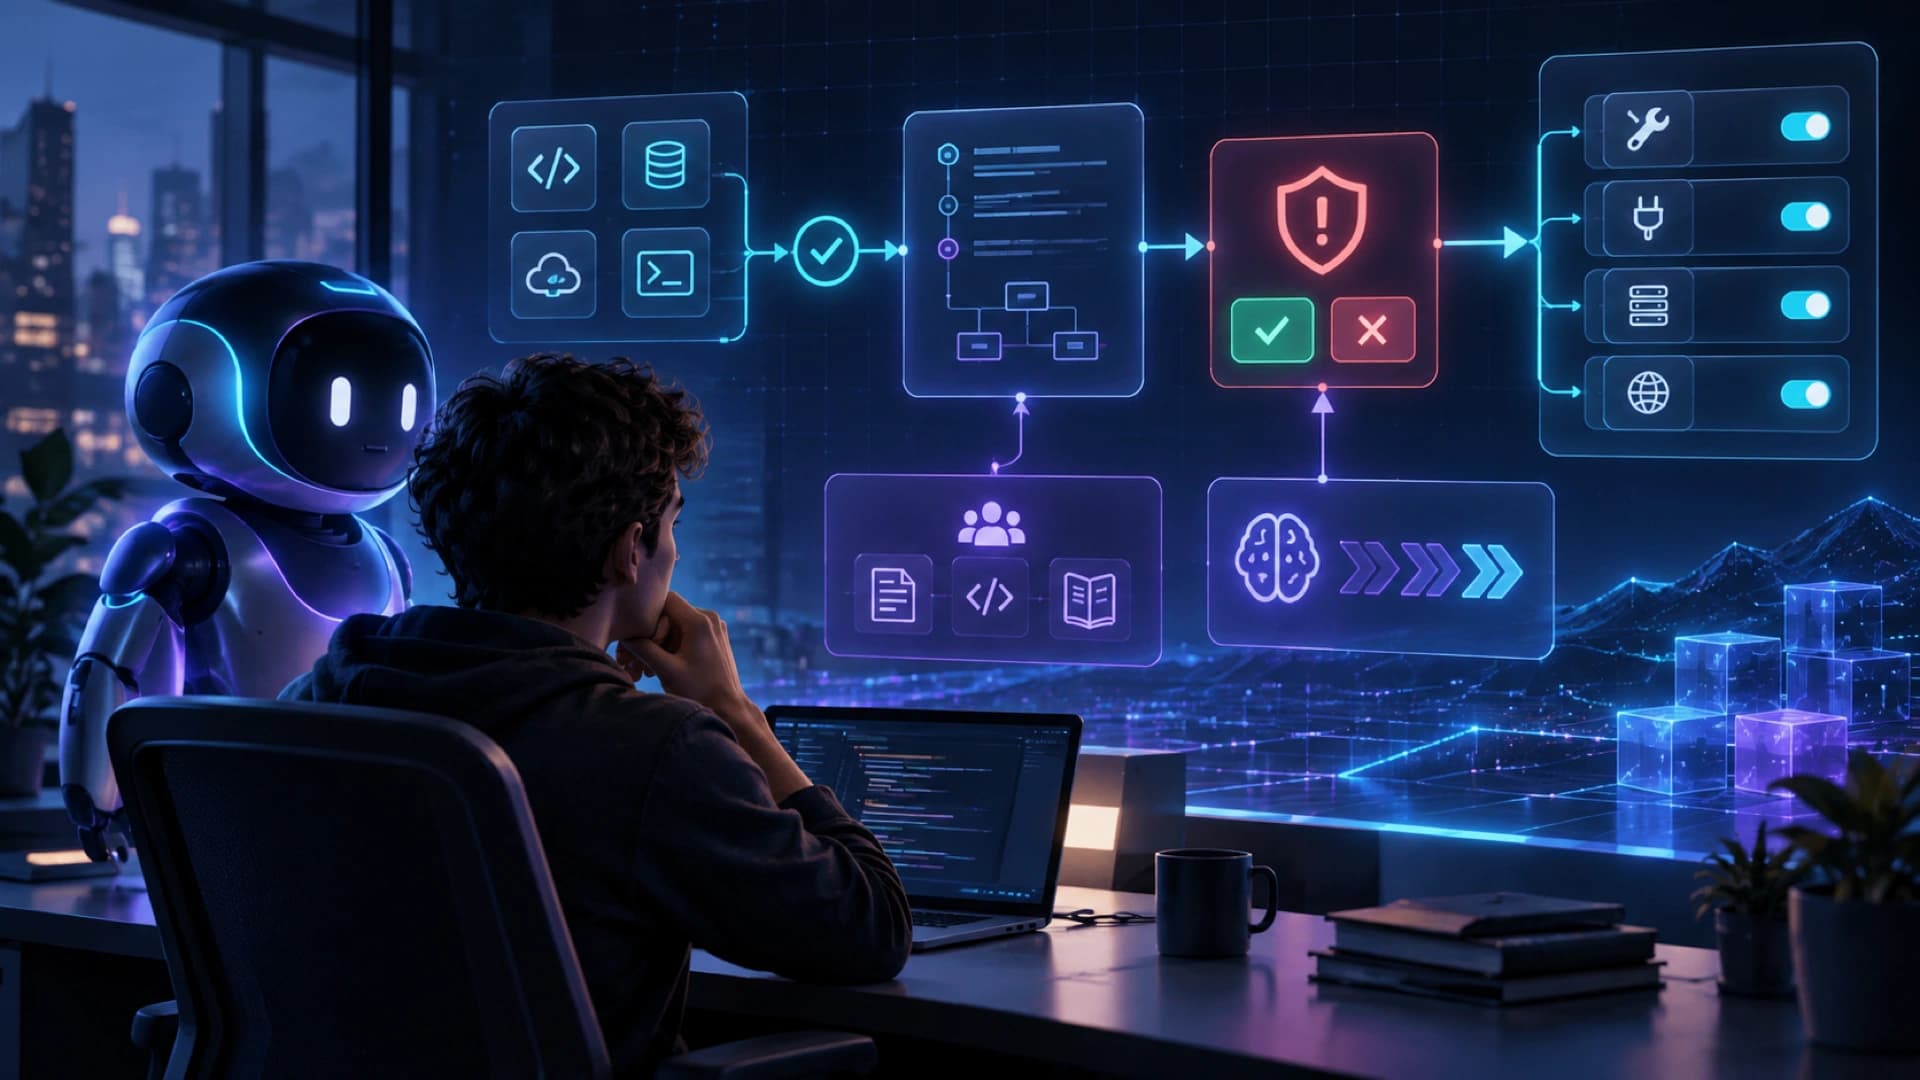
當 AI 需要讀取記憶時,使用者裝置會與受保護的雲端環境建立 authenticated、end-to-end encrypted channel。資料會在隔離的 secure enclave 內暫時解密,用於處理請求和寫入新的上下文,完成後再立即加密。Google 表示,硬件強制的 secure enclave、加密通道和由裝置衍生的每用戶資料庫密鑰共同構成這條保護鏈。
這個更新解決的是持久性與私隱之間的張力。此前的 Private AI Compute 被描述為 stateless:任務結束後便清除上下文。現在的方向是讓 AI 記得跨裝置的對話、偏好或正在處理的工作,例如在智能眼鏡看過裝配指引後,稍後在筆電上繼續使用。這類體驗可以更連貫,但也令記憶的範圍、刪除、復原和錯誤更正變得重要。
Google 同時表示,會發布更新的技術白皮書、伺服器軟件的 tamper-proof public record,以及讓裝置驗證軟件未被更改的機制;文章也提到一間獨立網絡安全公司完成的 audit。這些措施有助於外部審查,但 audit 的範圍、時間點和未覆蓋的威脅仍然決定證據的力度,不能只因為有 audit 一詞便推導出全面安全。
從產品設計角度看,伺服器端記憶不只是把資料庫加密。系統還要處理裝置遺失或更換、密鑰復原、使用者撤回同意、跨裝置同步、共享裝置、資料刪除,以及記憶被錯誤寫入後如何修正。這些是根據架構作出的工程推論,不是 Google 在文章中承諾的完整功能清單。
對 AI workflow 而言,持久記憶會令助手由一次性工具變成長期服務,因而需要更清楚的資料生命週期。哪些內容可以被記住、何時過期、誰可以讀取、模型如何引用來源,都應該成為可見的設定,而不是只藏在一個模糊的「personalization」開關後面。
Google 這次更新的意義,在於把雲端模型能力和裝置級私隱標準放到同一個架構問題中。若技術白皮書、公開記錄和獨立測試足夠詳細,社群可以檢查它是否真的達到宣稱的保護;在此之前,較準確的表述是 Google 正在提出一套可驗證的私密長期記憶設計,而不是私隱風險已經完全消失。