NVIDIA 於 2026 年 9 月 30 日介紹一條把 HSTU generative recommender 由 PyTorch 開發環境帶到 production inference 的流程。Generative recommender 把用戶互動、上下文、候選項目和行動歷史視為序列 token,模型根據這串事件去預測或排序下一個相關項目;它適合個人化推薦,但長歷史和大型 embedding table 會令 serving 變得昂貴。
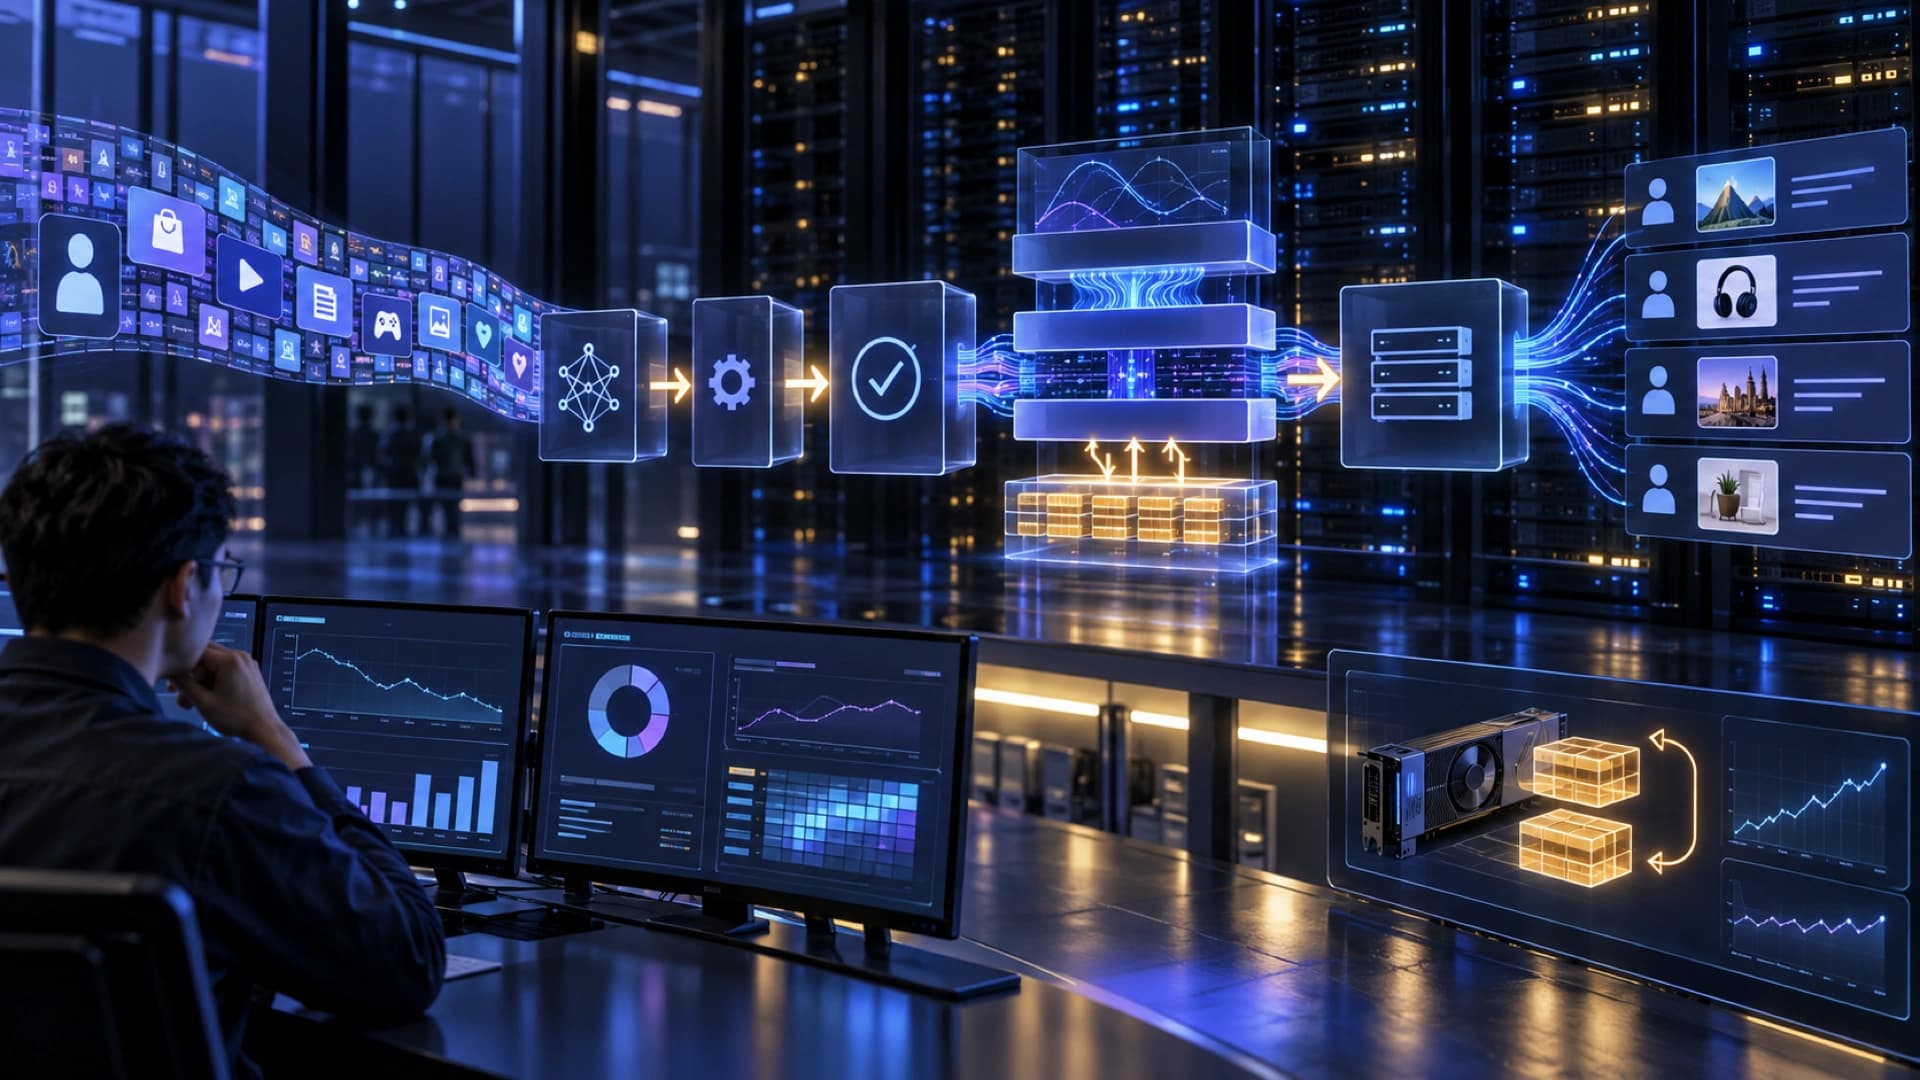
NVIDIA 的 end-to-end workflow 結合 HSTU、PyTorch Ahead-of-Time Inductor(AOTI)、FlexKV-backed KV caching、native C++ validation、NV Embedding Cache 和 Dynamo-Triton。AOTI 把模型 export 成可由 native C++ runtime 載入的部署 artifact;KV cache 則重用已計算的 user-history attention state,避免每次新請求都從頭處理不變的前綴。
在 NVIDIA 分享的單 GPU benchmark 中,使用 RTX PRO 6000 Blackwell Workstation Edition、dynamic batch size 8 及 100% GPU KV-cache hit rate,三層 HSTU 相對相同 AOTI、沒有 cache 的配置,最高 speedup 為 4.47 倍;八層模型最高為 5.93 倍。文章亦報告 cache 命中時,batch size 8 的三層及八層模型 latency 分別為 0.423ms 和 0.678ms。這些是供應商在 KuaiRand-1K ranking configuration 的技術 benchmark,不是所有推薦流量的保證。
部署流程把 export、編譯、cache service、C++ replay 驗證及 Dynamo-Triton serving 分成清楚階段。這種設計對 AI marketing、feed、廣告及電商推薦特別 relevant,因為 ranking latency 會直接影響頁面反應和 ad-serving deadline;但速度改善高度依賴歷史前綴可重用、GPU cache 命中率、記憶體容量及 eviction 策略。冷啟動、cache invalidation、資料新鮮度和不同用戶分布都需要另行量度。
文章的另一個重點是 development validation 和 production serving 使用相同的 exported artifact。Python export scripts 產生 package,再由 native C++ executable replay tensors 作正確性和效能驗證,最後交給 Dynamo-Triton。這比在另一個 runtime 重新實作模型少一層轉換,但仍不會自動解決推薦系統的資料權限、個人資料保護、偏差、探索與商業指標問題。
NVIDIA 的結果適合作為研究和工程起點,尤其是想把長序列推薦由模型研究推進至 serving 的團隊。閱讀 benchmark 時要把硬件、batch、序列長度、cache hit、資料載入是否計入等條件一併看;真正上線前,還要以自己的冷熱流量、延遲分位數、推薦品質、成本和用戶體驗重新驗證。