NVIDIA 於 2026 年 10 月 8 日分享 KGMON 團隊在 KDD Cup 2026 Data Agents competition 取得第二名的做法。比賽要求 agent 從 database、CSV、JSON、prose documents、PDF 和 briefing videos 等異構資料回答自然語言問題,而且不只是 retrieval:agent 需要選工具、跨資料來源推理、產生答案檔案,並處理分析流程中的陷阱。
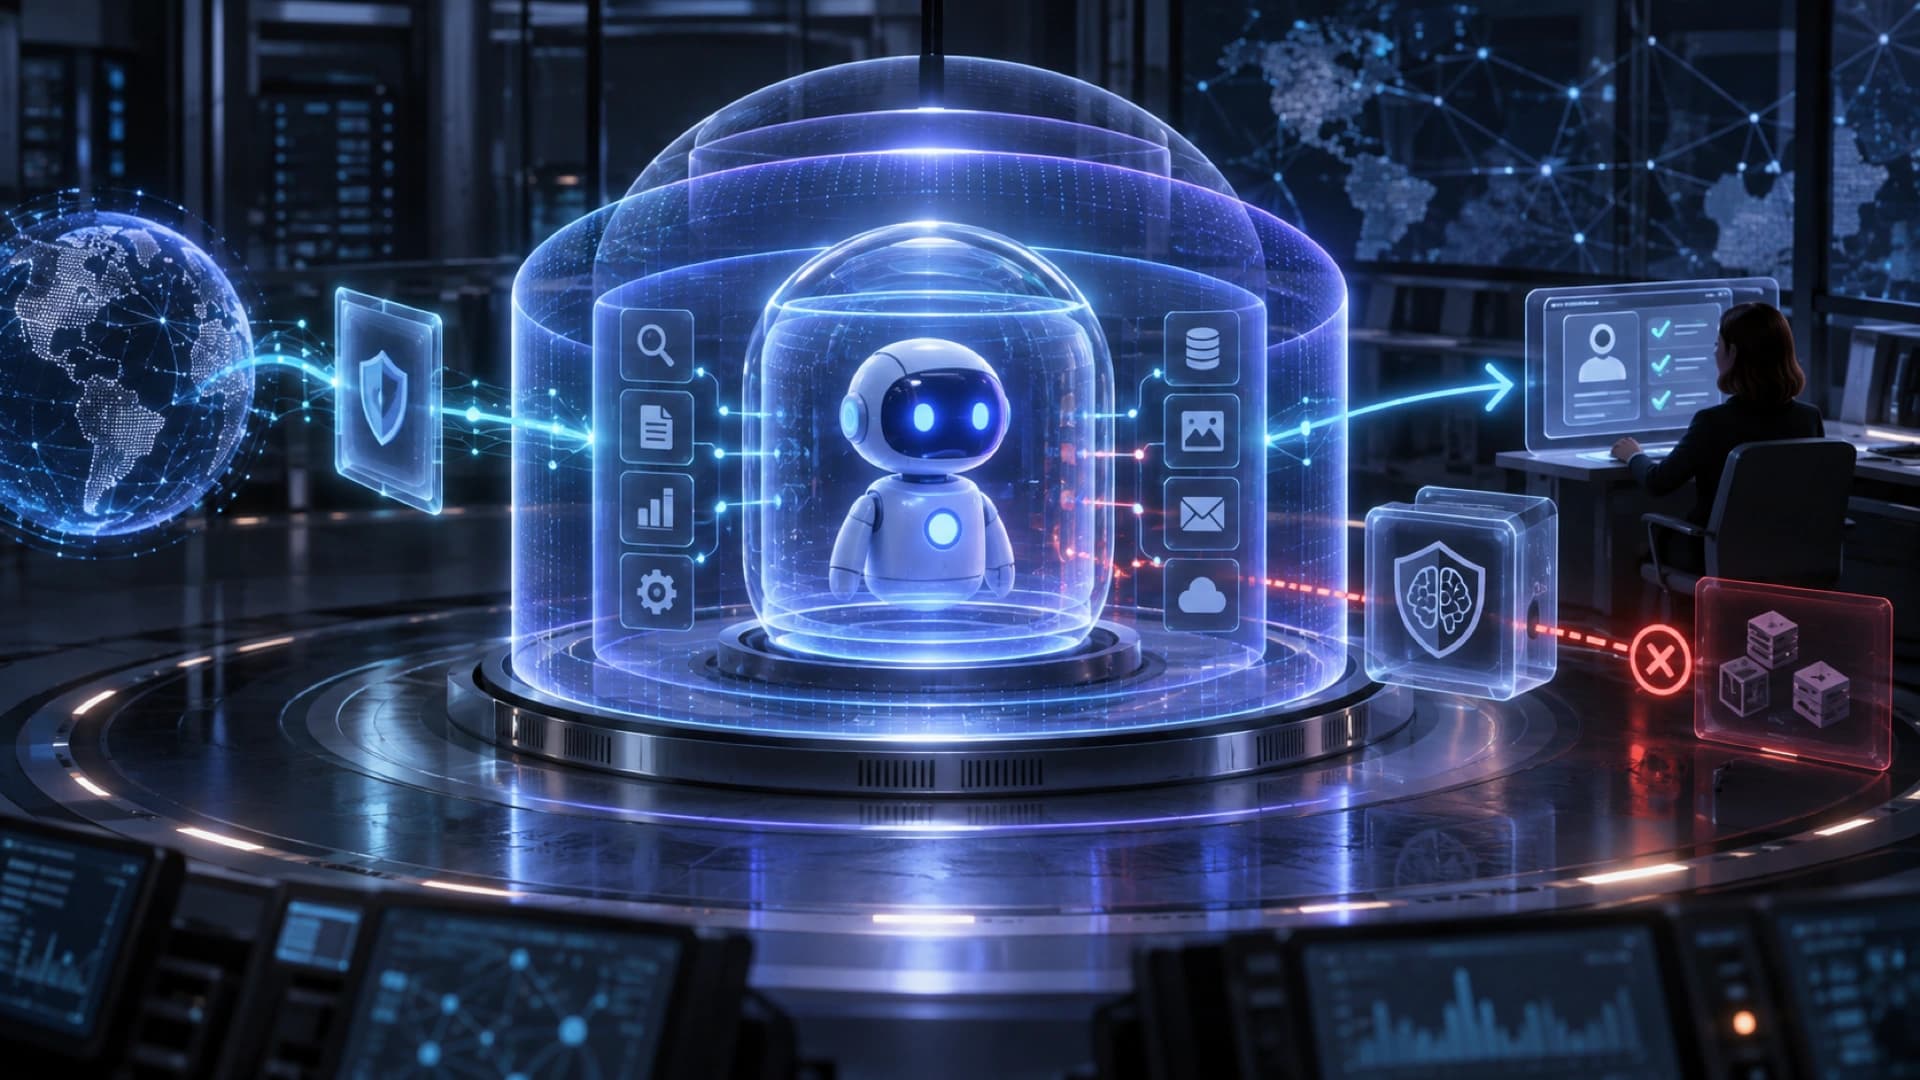
比賽使用一個 small fixed LLM,令主要優化面由換模型轉到 harness。KGMON 的核心取向有兩點:先限制 action space,避免 agent 有太多讀取資料、呼叫工具和修復錯誤的路徑;再讓每次嘗試都可檢查,保留 prompts、tool calls、SQL queries、中間結果、錯誤、修復和最後答案,方便人和另一個 inspector agent 找出第一個出錯位置。
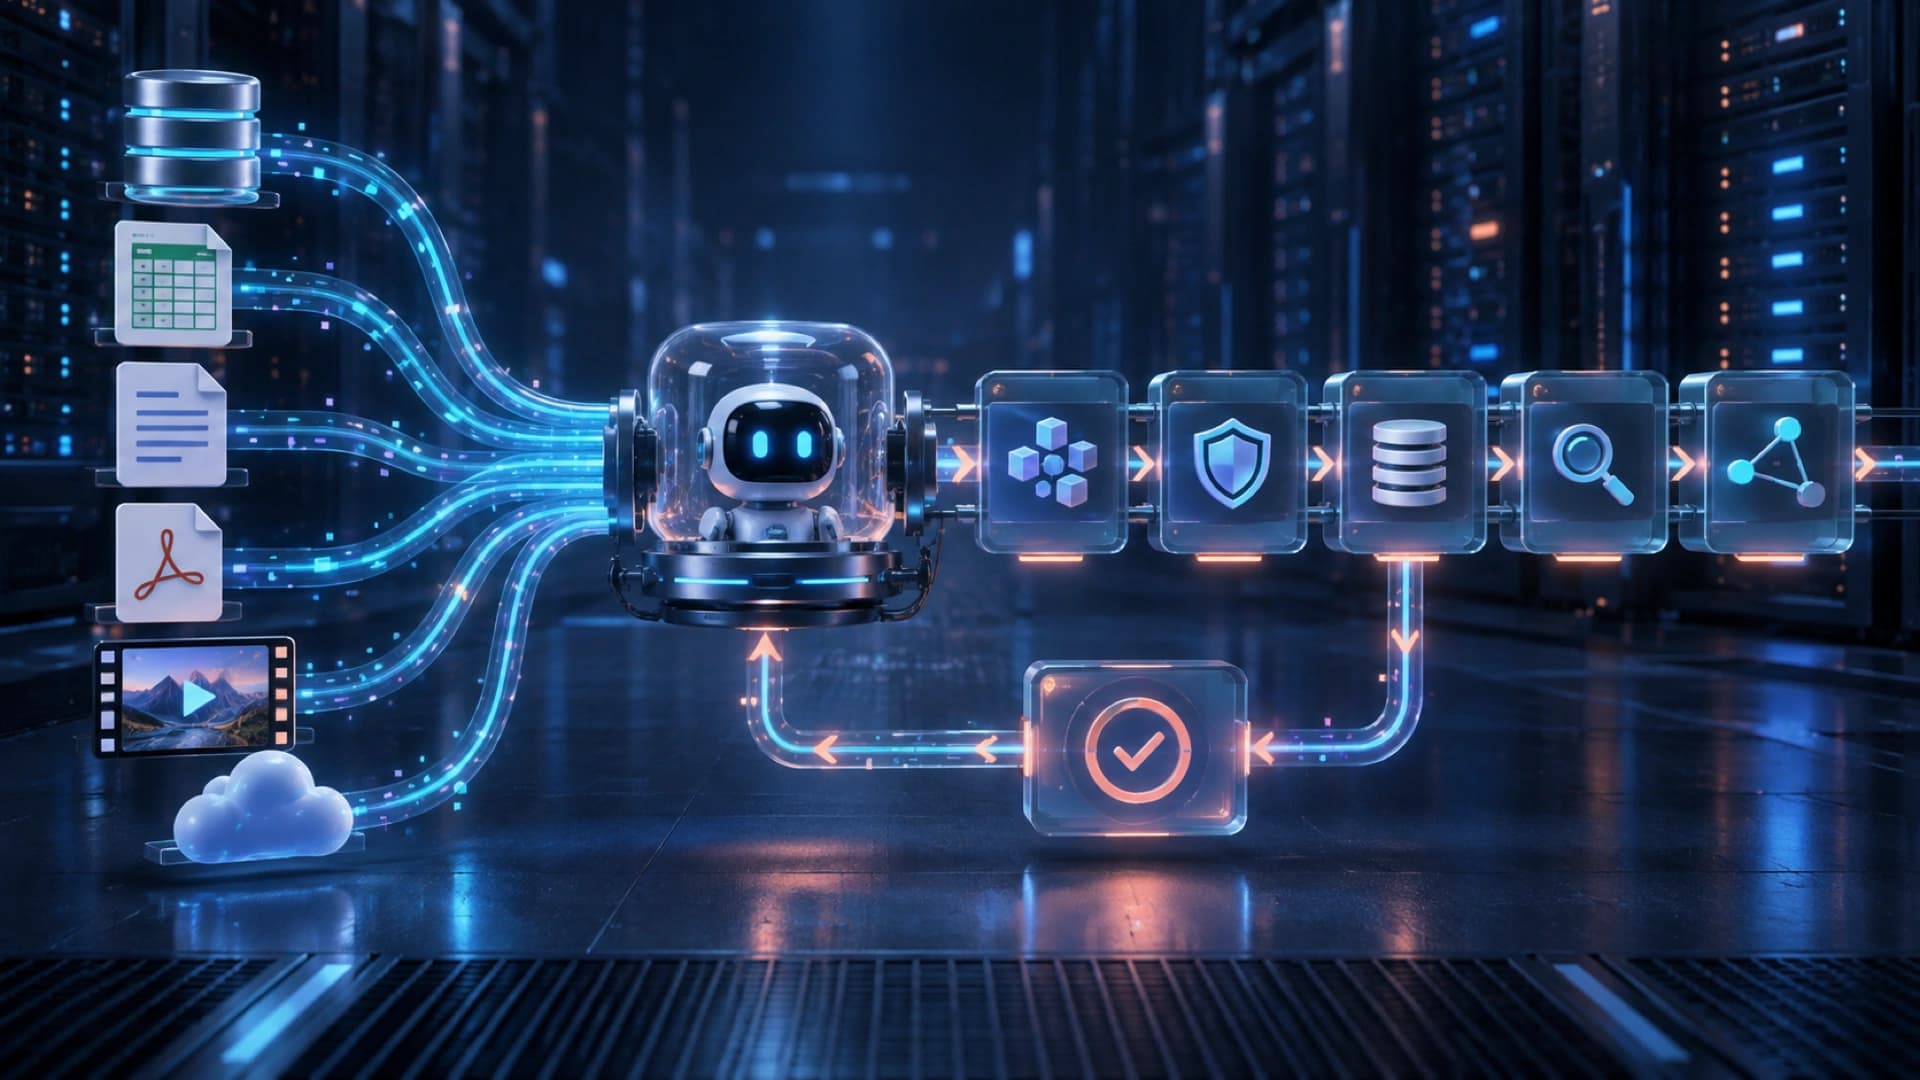
在 structured data 方面,團隊把 CSV 和 JSON 轉成現有 SQLite database 的 tables,讓 agent 只面對一個 query surface。自訂環境提供 schema() 和 sql(query);在主要 reasoning loop 開始前,schema-scout 會整理 tables、columns、可能 join keys、duplicate names、units、null patterns 和 row-grain 問題,減少 agent 先花多個回合猜資料結構。
KGMON 同時將工具面收窄到 schema inspection、SQL、prose lookup、答案寫入等少數 helper,包括 schema()、sql(query)、write_answer(df) 和 prose_helper()。middleware 會修復格式錯誤的 tool calls,persistent state 讓 agent 重用中間結果;文件則先用受限 preview 和 targeted search,再由另一個 zero-temperature LLM call 提取規則或表格,避免整份原文佔用主 agent context。
若任務有 briefing videos,系統會先抽取 keyframes、轉錄 audio,再把 transcript segments 對齊畫面,讓 agent 取得整理過的證據。這些 preprocessing 和工具設計都是配合比賽條件,不能直接當成所有 production data agent 的標準答案。NVIDIA 自己也提醒,競賽解法受到 fixed model、沒有 internet、異構 task bundles、value-level scoring 和長時間 budget 影響。
較可移植的教訓是:先把資料存取標準化,給 agent 一個小而可靠的工具面,記錄完整 execution traces,同時評估答案和 trajectory;改進時使用 held-out tasks,避免把 benchmark 例子硬編進 prompt。人手仍應定義成功條件、審核 trace、拒絕脆弱的修補,並在成本、風險和泛化能力都可接受後才把改動納入 harness。