一篇于 2026 年 8 月 7 日提交到 arXiv、并标示为获 ASE 2026 接受的研究提出 AgentChaos,将 chaos engineering 的故障注入方法应用到 agent systems。研究重点不是比较哪个 LLM 的答案最好,而是在 runtime 期间有系统地破坏 agent workflow 的不同部分,再观察系统能否感知和处理故障。
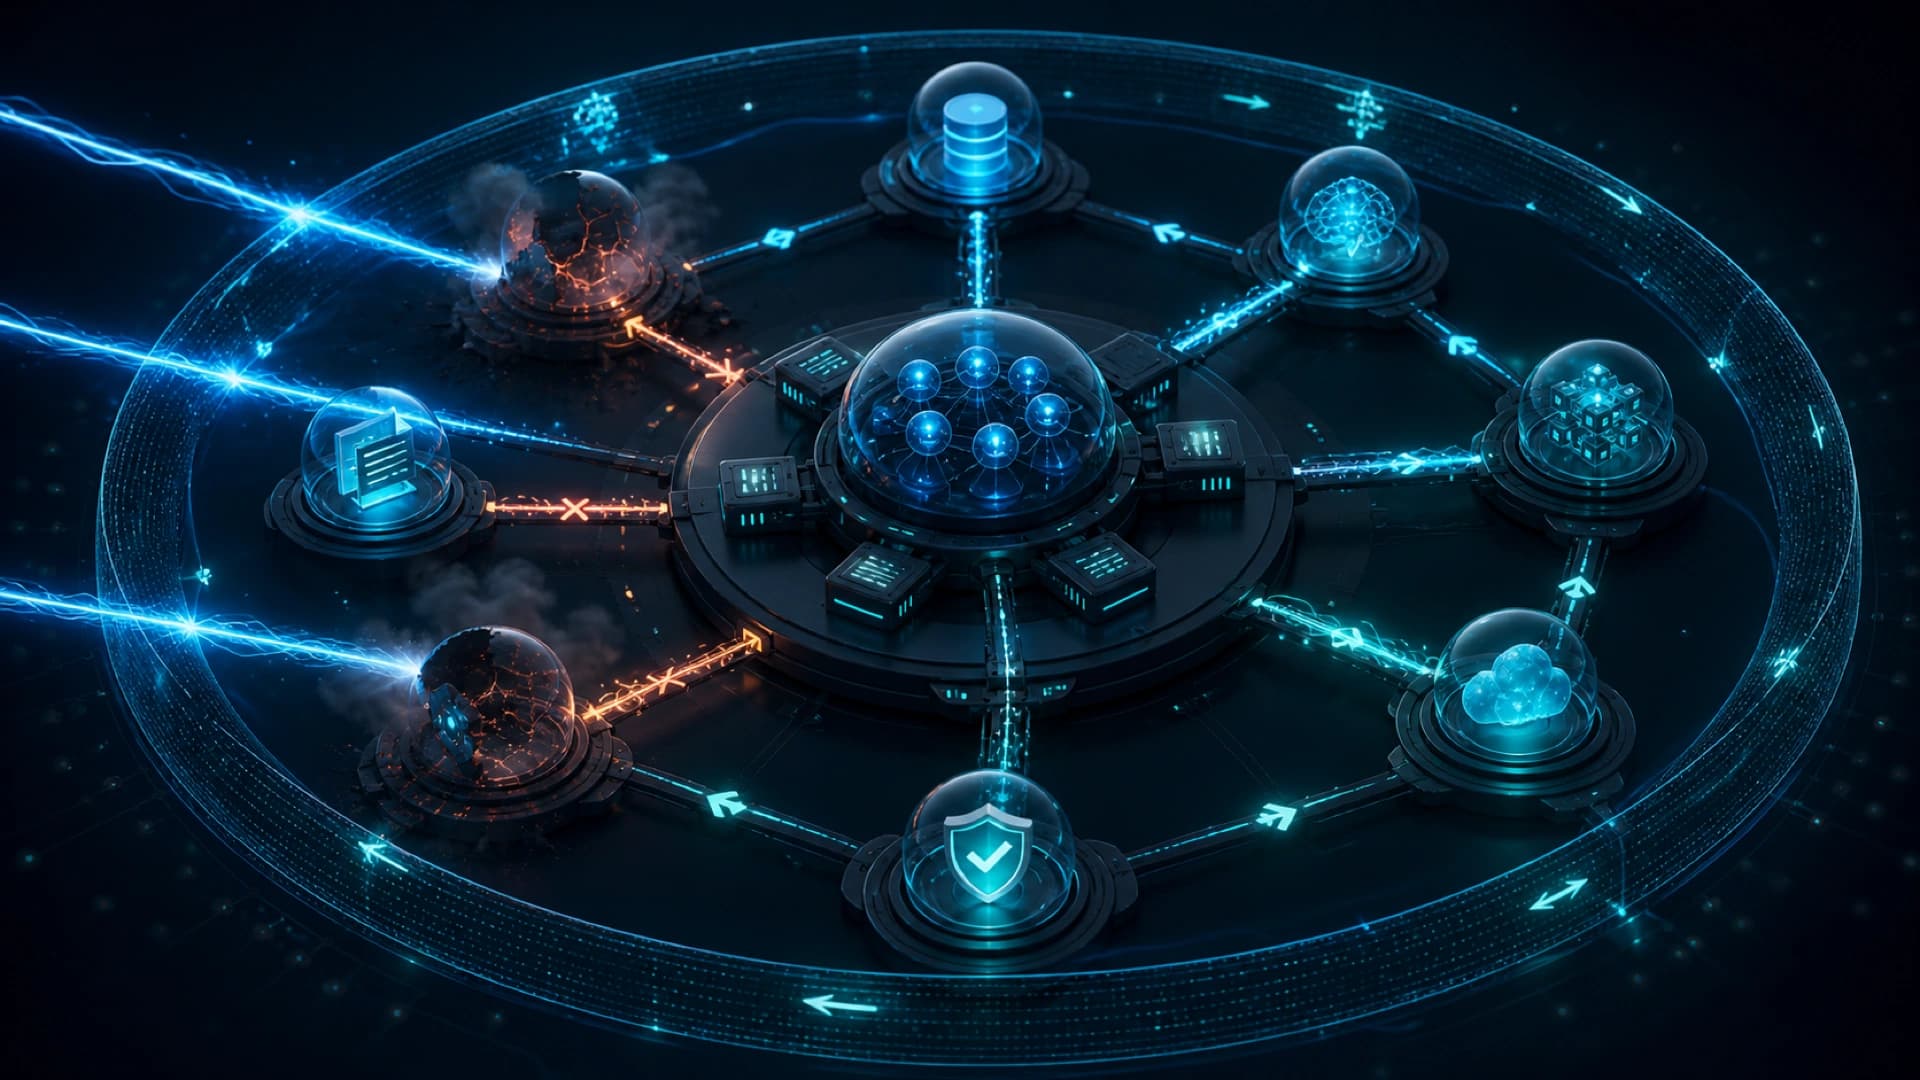
AgentChaos 在共享 HTTP layer 做非侵入式 fault injection,因此不需要重写每个 agent framework。研究描述的 fault types 包括 crash、omission 和 value faults,目标字段可以是消息内容或 tool-call 字段。系统还会验证 fault 是否真的被触发,避免测试看似执行了,实际上没有改变被测流程。
这种测试方式很接近 production agent 的真实失败形态。agent 可能收到格式正确但内容错误的工具响应、丢失一个必要事件、在中途崩溃,或者把不安全的参数传给下游服务。如果只测试模型在正常输入下的 pass@1,就很难知道 orchestrator、retry、timeout、state recovery 和人工升级是否真的有效。
论文在 65 个 configurations 上报告,故障注入可以让部分系统的 pass@1 下降最多 50 个百分点。作者还指出,不同模型的结果排名相当一致,说明 agent robustness 可能更多取决于系统实现,而不只是底层模型。这些结果属于研究者在其 benchmark 和配置下的报告,不能直接当成所有 production agent 的故障率。
AgentChaos 带来的工程启示,是 agent reliability 需要把「模型出错」和「系统处理错误的能力」分开验证。测试计划可以把工具错误、空响应、延迟、重复事件、错误格式和权限拒绝列成 fault matrix,再检查每种故障是否有清楚的 timeout、重试上限、幂等处理、告警和人工接管。
故障注入也要有安全边界。测试流量应在隔离环境运行,所有注入都要有 trace id 和可回放记录,并避免把破坏性 fault 传到真正的 production 数据。对于有租户和敏感数据的系统,fault harness 本身也要遵守最小权限和数据脱敏。
如果 agent workflow 会自动修改代码、发送消息或调用外部交易服务,故障测试尤其重要。理想结果不是「任何 fault 都不会让任务失败」,而是系统能在失败时停止在可接受的状态,向用户说明原因,并且不会重复执行不可逆的副作用。
AgentChaos 将 agent 测试从静态 benchmark 推向 runtime resilience。当 agent 逐渐接入更多工具和长流程,能否在受控故障下被观察、诊断和恢复,会和模型本身的推理能力一样影响可用性。