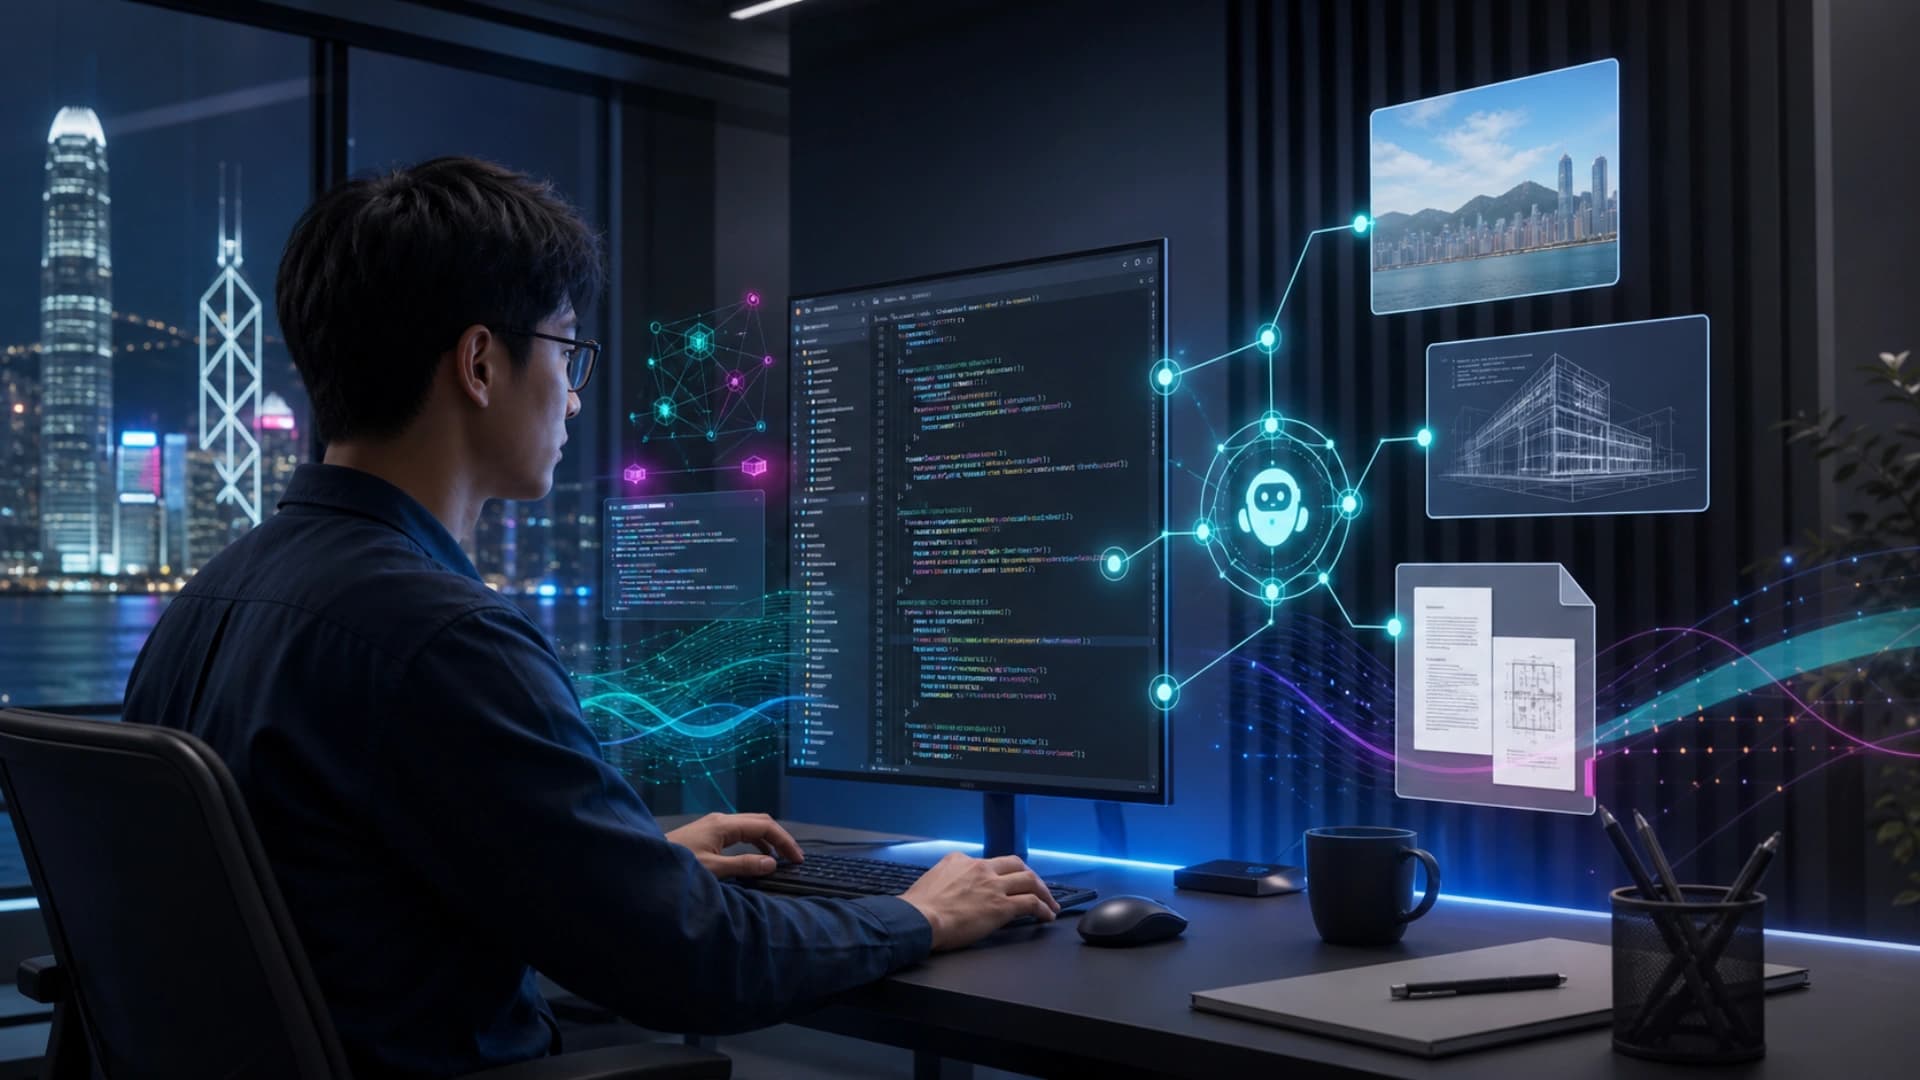
GitHub 在 2026 年 7 月 1 日宣布 Copilot Vision 正式可用。这个更新的重点,是开发者可以把图片和 PDF 直接附加到 Copilot Chat prompt,让 Copilot 在回答时同时理解视觉资料和 codebase 上下文。
这对前端、产品和设计交付很实际。很多工程任务不是只看代码就能判断,例如设计稿、客户截图、错误画面、PDF 规格、流程图和报告附件。过去 developer 要先把画面内容翻译成文字,再要求 AI 修改程序;现在 Copilot 可以直接把视觉素材纳入 reasoning loop。
GitHub 说明支持图片和 PDF,并把功能带到多个 Copilot plan。这代表 multimodal coding 不再只是 demo,而是开始变成日常开发工具。当 agent 可以看见 screenshot、读到规格 PDF、再结合 repo 内容提出修改,很多「照图改 UI」和「按文件补逻辑」的工作会更容易被委派。
对企业来说,这也会改变需求交付流程。产品、营销或运营同事可以把视觉参考、报表或客户提交的附件交给工程团队,工程师再用 Copilot 将这些材料转成具体修改。真正的价值不只是少打几句 prompt,而是减少上下文转译和反复澄清。
不过 multimodal agent 也需要治理。图片和 PDF 可能包含客户资料、商业文件、截图中的 token 或内部系统画面。团队要建立清晰规则:哪些文件可以给 Copilot、哪些要先遮蔽、哪些任务仍要人工审查。
Copilot Vision GA 的讯号,是 AI coding 正由纯文字辅助走向「看见工作材料」的阶段。当 agent 能理解设计、文件和代码之间的关系,开发流程会更接近真实工作委派,而不是只是一问一答。