NVIDIA 于 2026 年 9 月 21 日发表一篇关于 AI agent evaluation 的技术文章,核心观察很直接:代理说得像完成工作,不代表工作真的完成。当代理要在真实环境中连续调用工具、处理错误和更新状态,单次回答或单一 function call 的分数不足以判断整个任务。
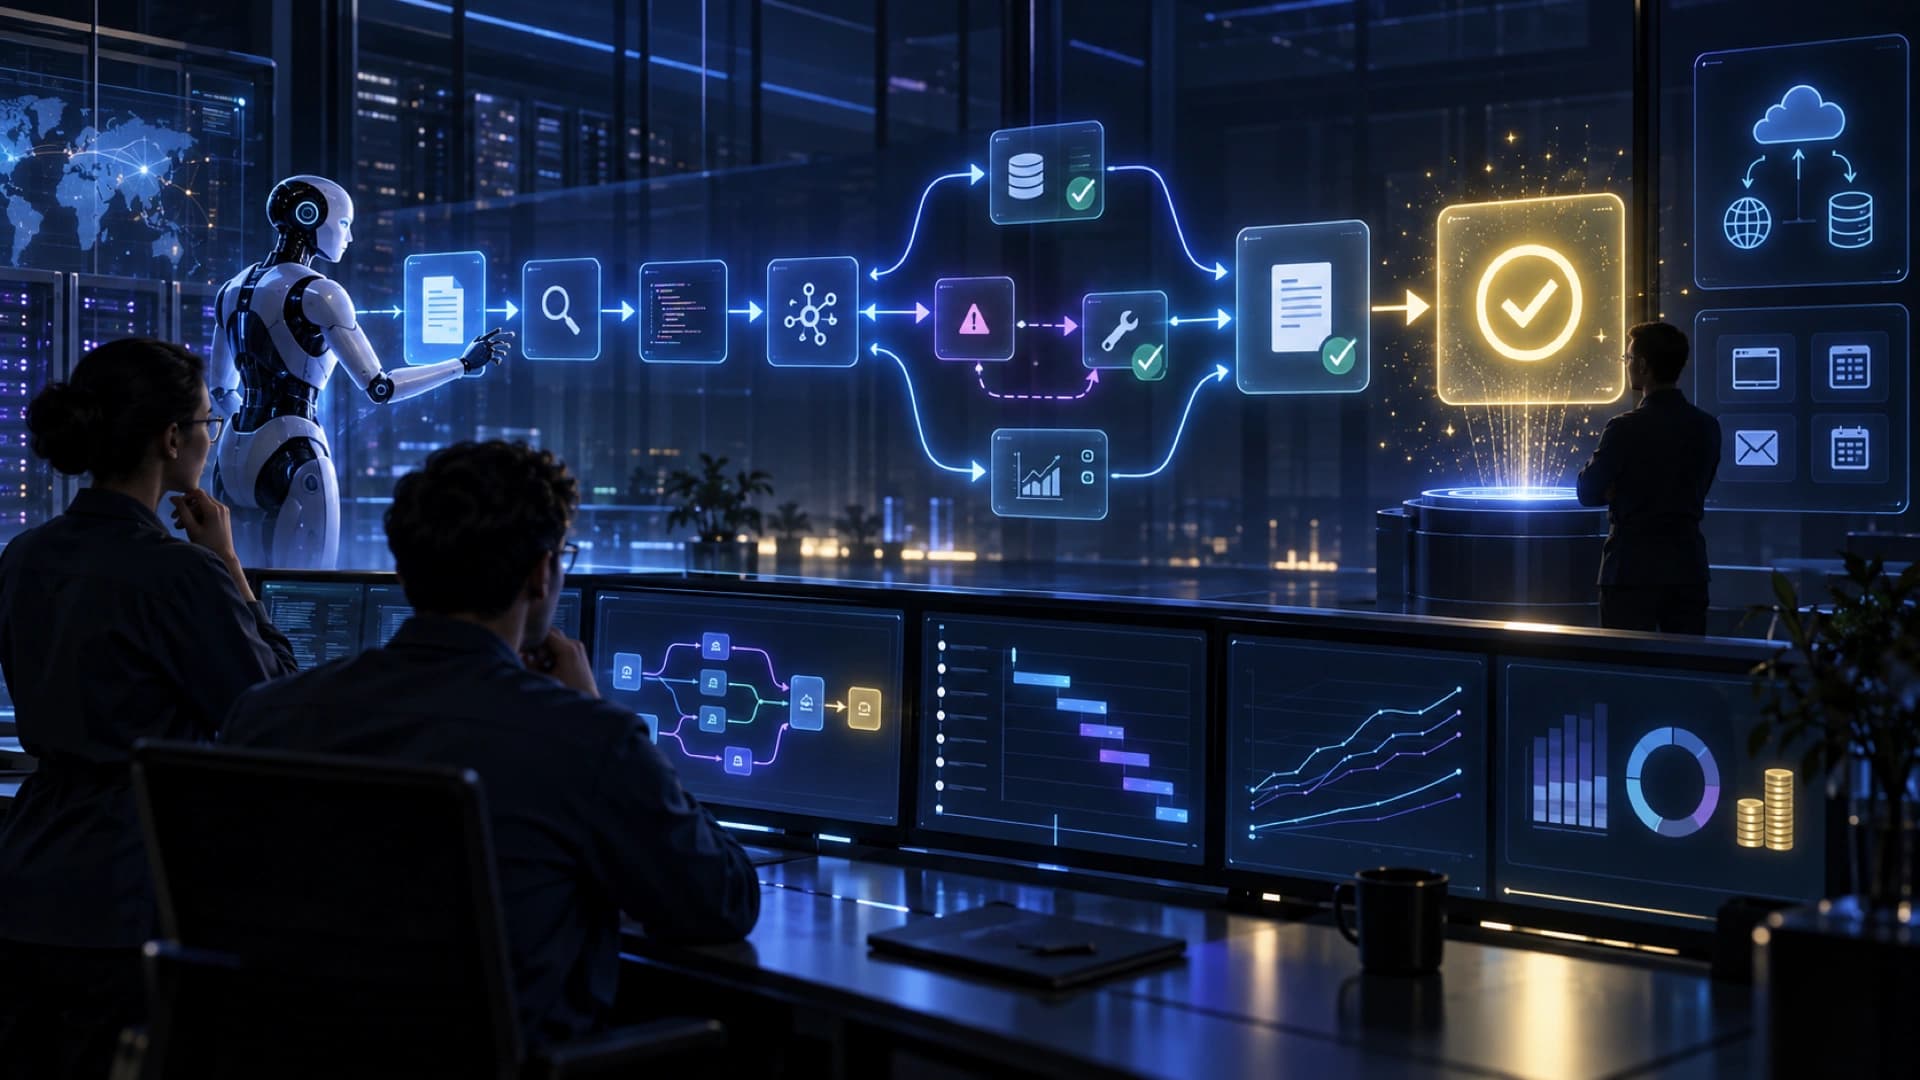
文章建议评估环境要真正执行每个工具调用、追踪多步骤状态,再检查最后世界是否到达目标。例如退款代理不只要调用正确的 refund API,还要确认必要检查已完成、记录已更新、退款真的在系统内生效。这种 outcome-oriented 评估比「模型选中哪个工具」更接近用户实际感受到的结果。
NVIDIA 把评分拆成两层。Step-level process scoring 检查某一步在当时的状态下是否有效、相关和有用;end-to-end outcome scoring 则只检查最后状态,例如工单是否正确分流或数据库是否真的更新。前者适合找出链条在哪一步断裂,后者则是生产环境真正要守住的完成门槛。
两层分数都应该连到同一份 trace。Trace 是一次尝试的有序记录,包含用户输入、每一步行动,以及任务结束时的环境状态。没有这条记录,团队只会知道任务失败,却不知道是工具选错、参数错误、状态漂移、权限拒绝,还是代理在第九步失去上下文。
文章列出一组比单一 accuracy 更实用的指标:task success rate 量度环境是否到达目标;consistency 看 3 至 5 次试验的成功率范围;tool-call precision 找出幻觉工具或多余调用;argument accuracy 分开工具选对但参数填错的情况;steps per success 和 cost per success 则衡量完成一项成功工作需要多少步骤和资源。
NVIDIA 也提醒,不同 benchmark 即使都声称测试 tool calling,结果也未必可以直接比较。任务复杂度、环境是否有状态、是否需要错误恢复,以及验证方式都会改变含义。可执行的验证,例如测试真的通过或数据库真的更新,通常比只靠 reference answer 或 LLM-as-a-Judge 更可靠;后者仍需要用人工样本校准。
另一个限制是 contamination。会联网搜索的代理可能在评估期间找到答案,公开数据集也可能很快被重新抓取到训练数据。文章因此提到 private domain eval 的价值:把实际 API、政策和企业任务放进不能被公开搜索的测试环境,并以 environment state 作 release gate。这不是保证没有偏差,但能减少只测文字答案的盲点。
对部署 AI workflow 的团队而言,这套方法把「代理表现好不好」变成一个可操作的工程问题。先定义完成状态,再记录 trace,分开看过程和结果,最后才比较模型、harness 或 prompt。代理如果只在 demo 中回答得漂亮,却不能稳定完成真实工作,应该被视为尚未通过生产评估。