NVIDIA 於 2026 年 9 月 21 日發表一篇關於 AI agent evaluation 的技術文章,核心觀察很直接:代理說得像完成工作,不代表工作真的完成。當代理要在真實環境中連續呼叫工具、處理錯誤和更新狀態,單次回答或單一 function call 的分數不足以判斷整個任務。
文章建議評估環境要真正執行每個工具呼叫、追蹤多步驟狀態,再檢查最後世界是否到達目標。例如退款代理不只要呼叫正確的 refund API,還要確認必要檢查已完成、記錄已更新、退款真的在系統內生效。這種 outcome-oriented 評估比「模型選中哪個工具」更接近使用者實際感受到的結果。
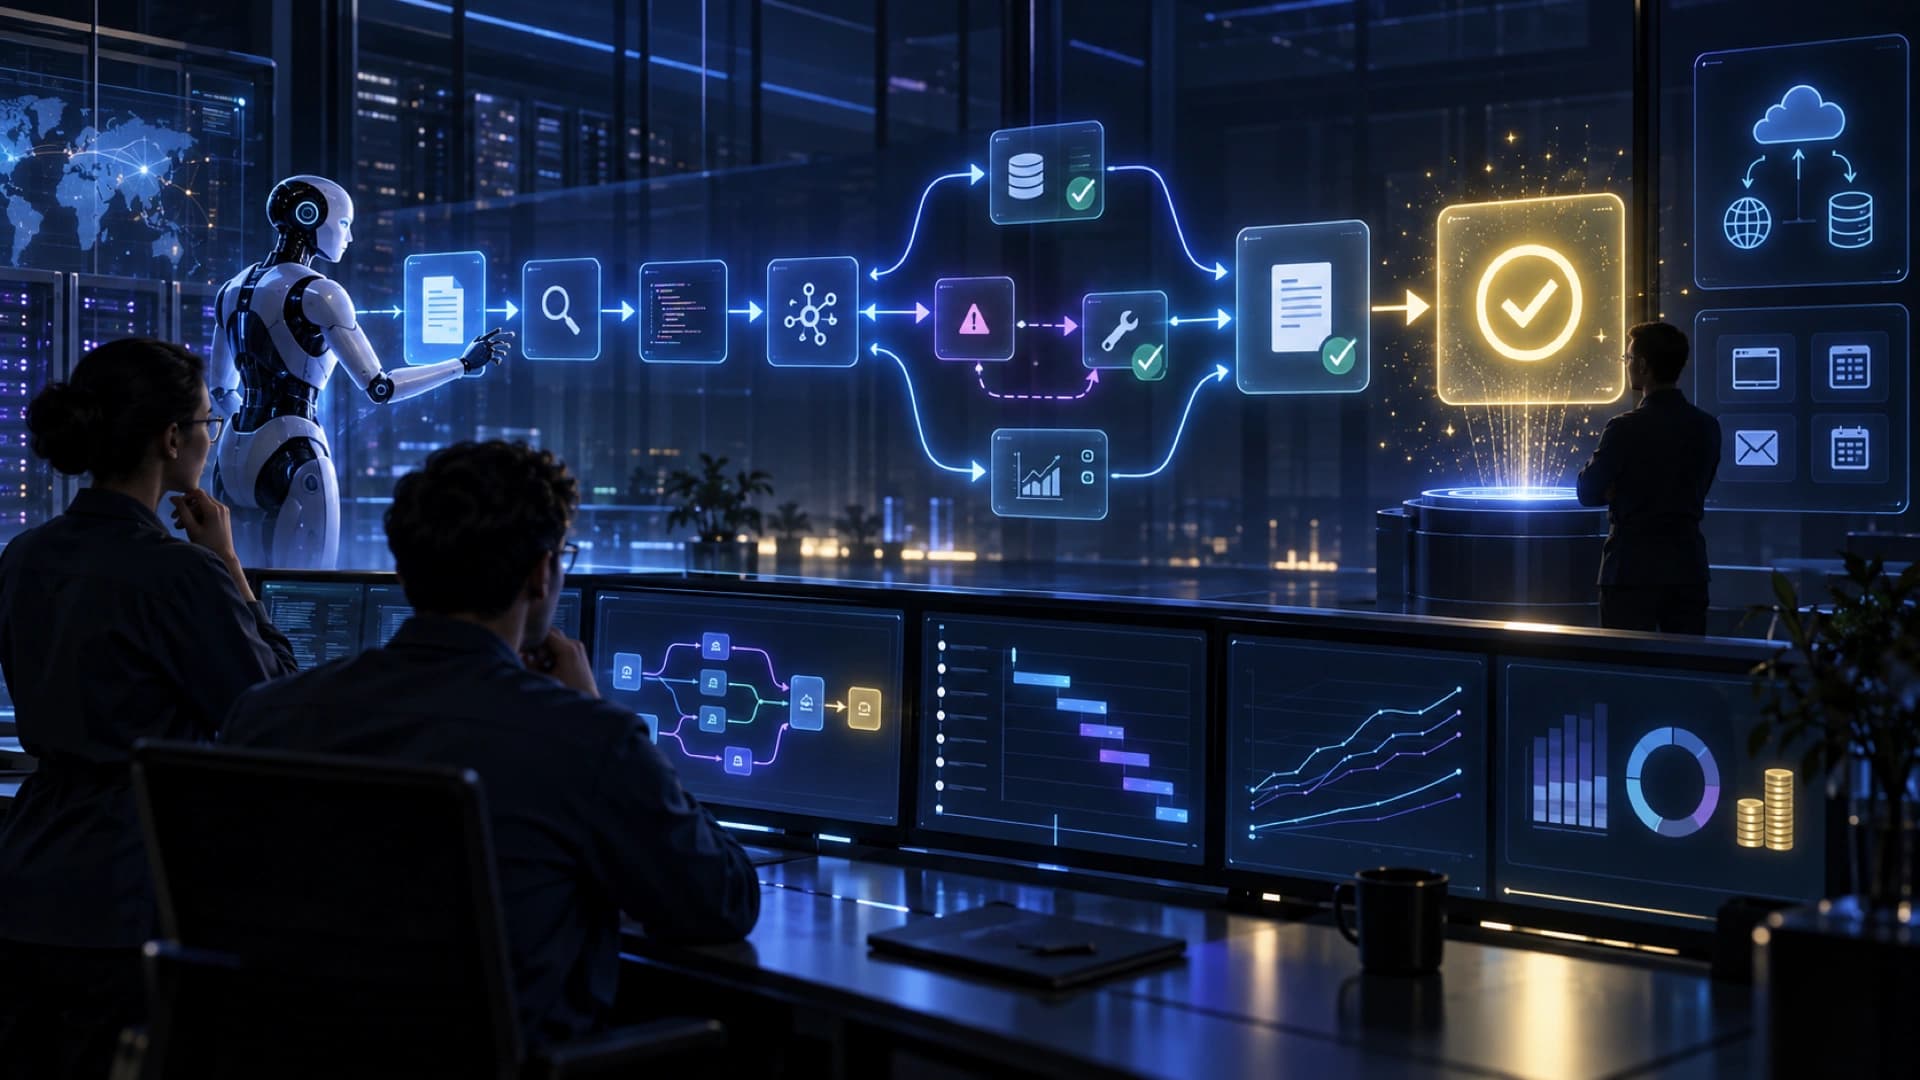
NVIDIA 把評分拆成兩層。Step-level process scoring 檢查某一步在當時的狀態下是否有效、相關和有用;end-to-end outcome scoring 則只檢查最後狀態,例如工單是否正確分流或資料庫是否真的更新。前者適合找出鏈條在哪一步斷裂,後者則是生產環境真正要守住的完成門檻。
兩層分數都應該連到同一份 trace。Trace 是一次嘗試的有序紀錄,包含使用者輸入、每一步行動,以及任務結束時的環境狀態。沒有這條紀錄,團隊只會知道任務失敗,卻不知道是工具選錯、參數錯誤、狀態漂移、權限拒絕,還是代理在第九步失去上下文。
文章列出一組比單一 accuracy 更實用的指標:task success rate 量度環境是否到達目標;consistency 看 3 至 5 次試驗的成功率範圍;tool-call precision 找出幻覺工具或多餘呼叫;argument accuracy 分開工具選對但參數填錯的情況;steps per success 和 cost per success 則衡量完成一項成功工作需要多少步驟和資源。
NVIDIA 亦提醒,不同 benchmark 即使都聲稱測試 tool calling,結果也未必可直接比較。任務複雜度、環境是否有狀態、是否需要錯誤回復,以及驗證方式都會改變含義。可執行的驗證,例如測試真的通過或資料庫真的更新,通常比只靠 reference answer 或 LLM-as-a-Judge 更可靠;後者仍需要用人工樣本校準。
另一個限制是 contamination。會上網搜尋的代理可能在評估期間找到答案,公開資料集也可能很快被重新抓取到訓練資料。文章因此提到 private domain eval 的價值:把實際 API、政策和企業任務放進不能被公開搜尋的測試環境,並以 environment state 作 release gate。這不是保證沒有偏差,但能減少只測文字答案的盲點。
對部署 AI workflow 的團隊而言,這套方法把「代理表現好不好」變成一個可操作的工程問題。先定義完成狀態,再記錄 trace,分開看過程和結果,最後才比較模型、harness 或 prompt。代理如果只在 demo 中回答得漂亮,卻不能穩定完成真實工作,應該被視為尚未通過生產評估。