NVIDIA 于 2026 年 9 月 30 日介绍一条把 HSTU generative recommender 从 PyTorch 开发环境带到 production inference 的流程。Generative recommender 把用户互动、上下文、候选项目和行动历史视为序列 token,模型根据这串事件去预测或排序下一个相关项目;它适合个性化推荐,但长历史和大型 embedding table 会让 serving 变得昂贵。
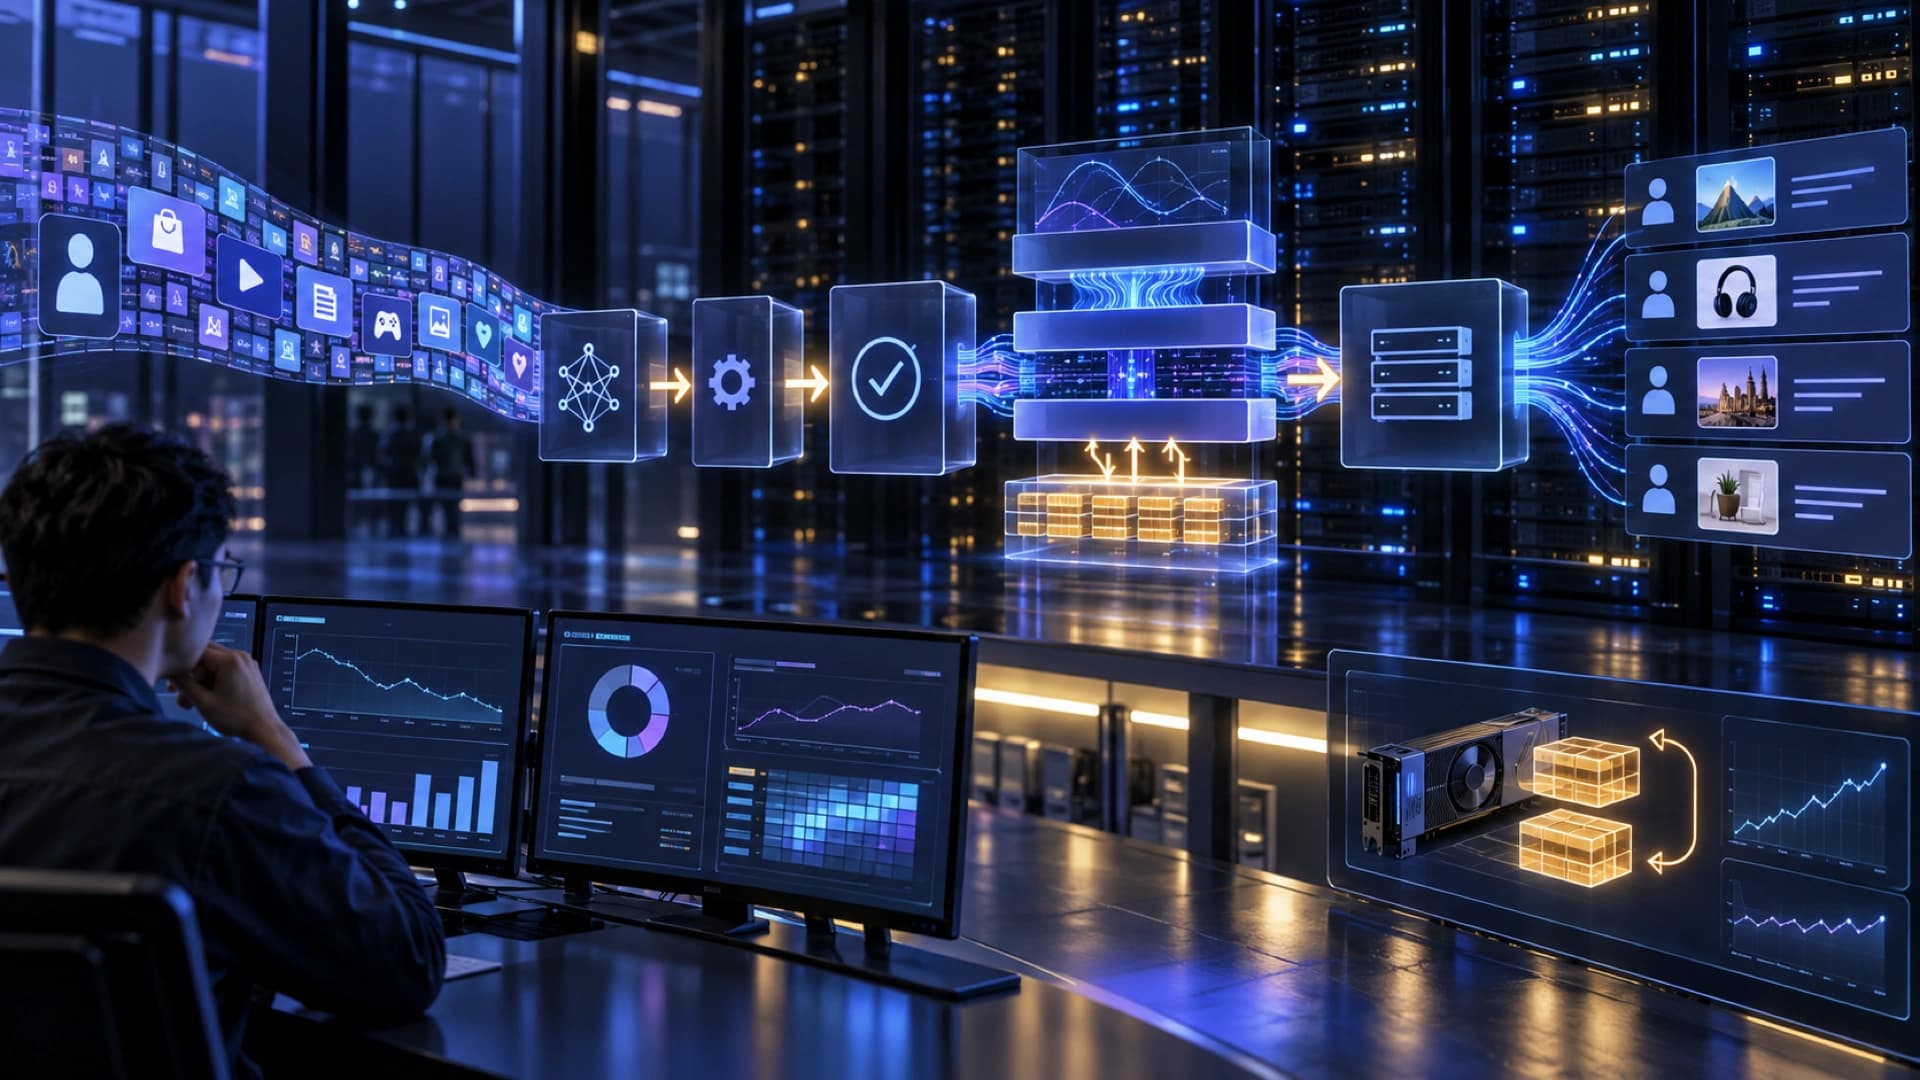
NVIDIA 的 end-to-end workflow 结合 HSTU、PyTorch Ahead-of-Time Inductor(AOTI)、FlexKV-backed KV caching、native C++ validation、NV Embedding Cache 和 Dynamo-Triton。AOTI 把模型 export 成可由 native C++ runtime 加载的部署 artifact;KV cache 则重用已经计算的 user-history attention state,避免每次新请求都从头处理不变的前缀。
在 NVIDIA 分享的单 GPU benchmark 中,使用 RTX PRO 6000 Blackwell Workstation Edition、dynamic batch size 8 及 100% GPU KV-cache hit rate,三层 HSTU 相对相同 AOTI、没有 cache 的配置,最高 speedup 为 4.47 倍;八层模型最高为 5.93 倍。文章也报告 cache 命中时,batch size 8 的三层及八层模型 latency 分别为 0.423ms 和 0.678ms。这些是供应商在 KuaiRand-1K ranking configuration 的技术 benchmark,不是所有推荐流量的保证。
部署流程把 export、编译、cache service、C++ replay 验证及 Dynamo-Triton serving 分成清楚阶段。这种设计对 AI marketing、feed、广告及电商推荐特别 relevant,因为 ranking latency 会直接影响页面反应和 ad-serving deadline;但速度改善高度依赖历史前缀可重用、GPU cache 命中率、内存容量及 eviction 策略。冷启动、cache invalidation、数据新鲜度和不同用户分布都需要另行衡量。
文章的另一个重点是 development validation 和 production serving 使用相同的 exported artifact。Python export scripts 产生 package,再由 native C++ executable replay tensors 作正确性和性能验证,最后交给 Dynamo-Triton。这比在另一个 runtime 重新实现模型少一层转换,但仍不会自动解决推荐系统的数据权限、个人数据保护、偏差、探索与商业指标问题。
NVIDIA 的结果适合作为研究和工程起点,尤其是想把长序列推荐从模型研究推进至 serving 的团队。阅读 benchmark 时要把硬件、batch、序列长度、cache hit、数据加载是否计入等条件一起看;真正上线前,还要以自己的冷热流量、延迟分位数、推荐质量、成本和用户体验重新验证。