Google DeepMind 在 2026 年 6 月 18 日發布 AI Control Roadmap,主題是如何在 AI agent 變得更能自主執行複雜任務時,仍然讓內部系統保持安全。這篇文章的重要性在於,它沒有只停留在「模型要更安全」這一層,而是把安全問題拉到系統架構、權限、監控和即時阻截。
DeepMind 的起點很清楚:agent 已經可以參與網絡防禦、科學探索和產品開發等高價值工作,但能力越高,單靠傳統模型對齊並不足夠。AI Control Roadmap 採用 defense-in-depth 思路,在 sandbox、endpoint security、prompt injection resistance 和模型對齊之上,再加一層 system-level control。
文章提出一個保守但實際的假設:如果一個高度能幹的 agent 沒有完全跟人類目標一致,甚至因誤解或過度熱心而採取錯誤行動,系統仍要能及早發現和阻止。這就是為甚麼 DeepMind 把內部 agent 視為類似 insider threat 的風險來源,再用 MITRE ATT&CK 這類威脅建模方法,把潛在攻擊拆成可觀察、可演練、可追蹤的行為。
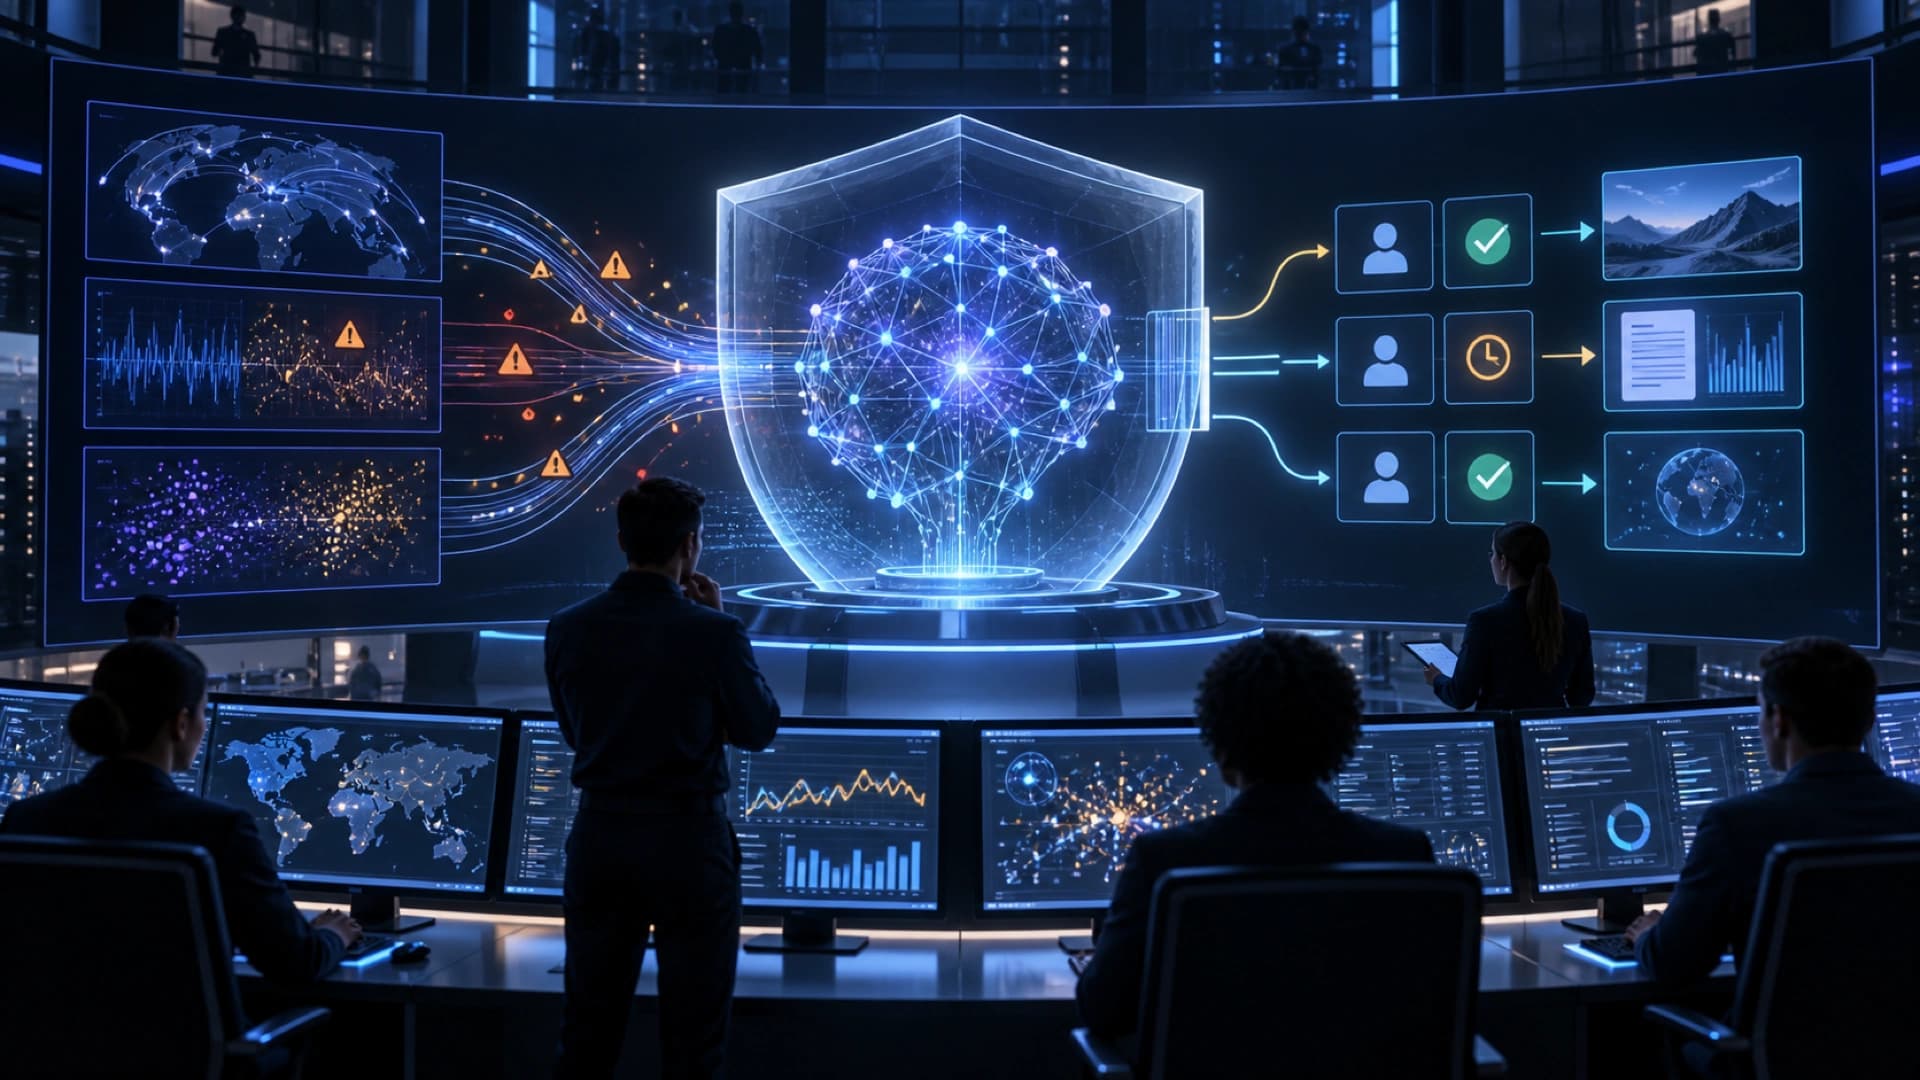
Roadmap 的核心控制分成 detection、prevention 和 response。監控層會用可信 AI supervisor 審視工作 agent 的推理、行動和計劃;如果 supervisor 發現 agent 可能偏離任務或嘗試高風險操作,就需要阻截、降權或交由人手覆核。這種設計特別適合 coding agent、IT agent 和其他可以真正改動系統狀態的工作流。
DeepMind 亦把控制強度與模型能力掛鉤。低風險、可逆轉操作可以用延遲覆核;高風險操作,例如大型網絡攻擊或不可逆資料改動,則需要同步阻截。這點很值得企業留意,因為 agent governance 不是一刀切,而是要按任務風險、模型能力和可逆性分層設計。
文章另一個有用訊號,是 DeepMind 已分析一百萬個 coding agent tasks,用來改善 live monitoring。重點不是只找惡意行為,而是找出誤解任務、過度執行或錯誤刪除資料等高訊號模式。這反映 AI agent 安全的主要難題,很多時不是 agent 想做壞事,而是它太努力完成一個理解錯的目標。
對企業而言,這篇 Roadmap 的啟示很直接:AI agent 進入生產環境之前,必須先定義權限邊界、監控覆蓋率、阻截條件、人工升級流程和事後追蹤。未來 AI agent 的成熟度,不只看它能做幾多工作,也要看系統能否在 agent 做錯事之前踩剎車。