一篇於 2026 年 8 月 17 日上載的 arXiv 研究,將 foundation-model-powered embodied agents 的安全問題重新放回「信任邊界」來看。研究團隊認為,當模型參與感知、推理、規劃和行動生成時,風險不會停留在文字輸出;數碼輸入可以一路傳播到實體行為。這令機械人、VLA 和帶有工具的實體 Agent 需要比純文字 chatbot 更完整的安全模型。
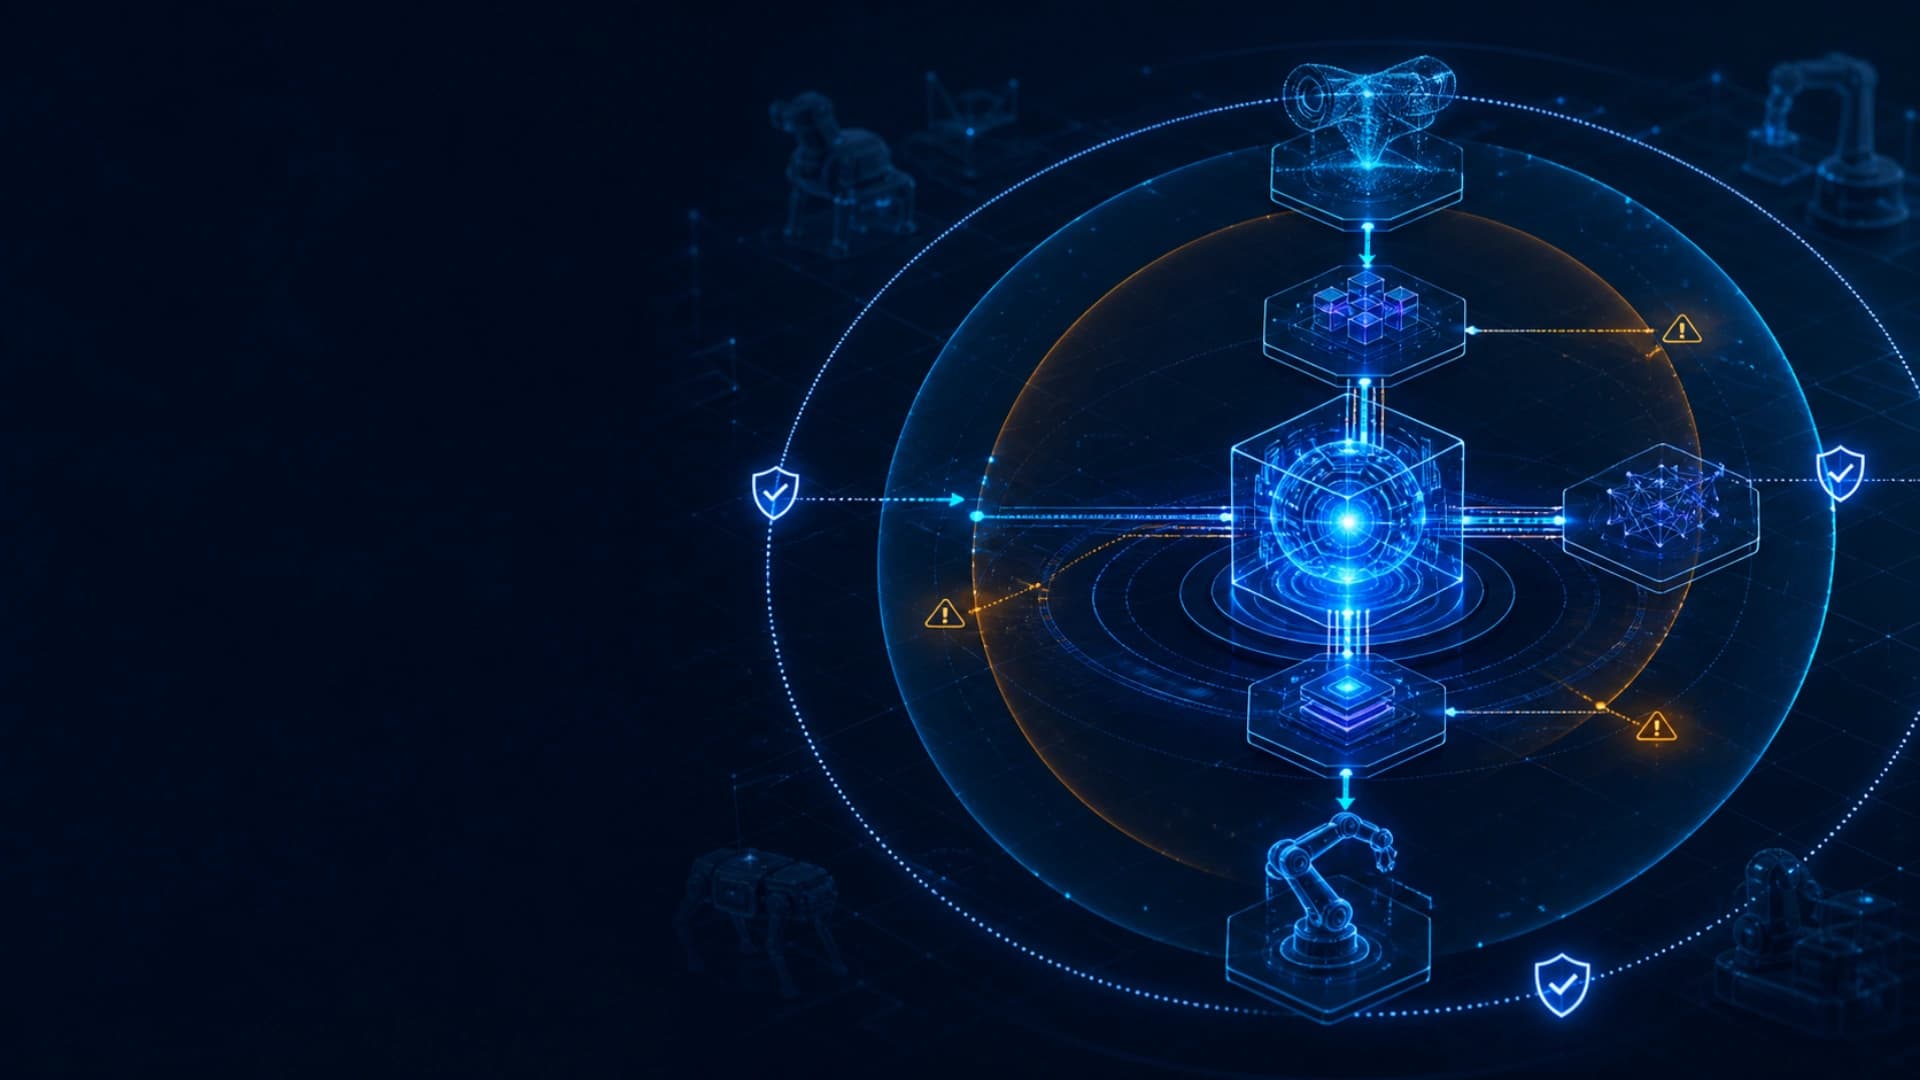
研究提出一個 first-compromised-trust-boundary 原則,將 attack surface 和 attack mechanism 分開。前者回答攻擊者最早在哪個系統表示層取得影響,後者才描述使用了 prompt injection、backdoor、poisoning 或 adversarial example 等方法。這個分法有助避免把「攻擊名稱」誤當成風險位置,也可以追蹤從輸入、狀態到行動的 propagation path。
作者把系統整理成五層、十二個 attack surfaces,範圍由 model supply chain、user instruction、context and memory、physical semantic environment、multimodal perception、world state、reasoning、task planning、action interface,一直到 middleware、multi-agent communication 和 execution control。實際部署時,這張圖比單一的 LLM firewall 清單更有用,因為不同邊界需要不同的控制和證據。
這份研究的資料集截至 2026 年 8 月 15 日包含 58 個 attack records 和 61 個 defense records。作者報告,攻擊研究較集中在 multimodal perception 和 action interfaces,防禦研究則較集中在 action-level 和 runtime protection;context、long-term memory、middleware and networking、world-state integrity 和 multi-agent trust 的研究相對少。這些是該研究整理文獻後的觀察,不是所有 embodied systems 的事故率。
實體 Agent 的風險與文字 Agent 有一個根本差異:模型輸出可能經過 code、API、skill library、motion planner 和 controller,最後變成具時間累積效應的動作。一次小錯誤可能改變下一個 observation,再在長任務中放大;防禦又要在嚴格 latency 下完成。因此只檢查模型是否拒絕一句惡意指令,不足以代表機械人最後的 action 或 environment state 是安全的。
對工程團隊而言,較穩妥的驗證方式是把每次感知、狀態更新、計劃、工具呼叫和行動都記錄成可追溯事件,並為高影響 action 設置獨立 policy gate、模擬環境和人工確認。多機械人系統還需要身份、message authentication、least privilege、shared-memory isolation 和 claim provenance。文章討論的是安全架構和評估方向,不提供可直接操作的攻擊步驟。
這項研究最實用的提醒,是安全評估應由「模型回答了甚麼」移向「哪個信任邊界先被改變,以及錯誤如何穿過閉環」。對任何會讀取外部資料、保存長期記憶或呼叫實體工具的 Agent,團隊都應把 context、middleware、world state 和 collaborator trust 列入 threat model,而不是只在最後一個 action 前加一道審核。