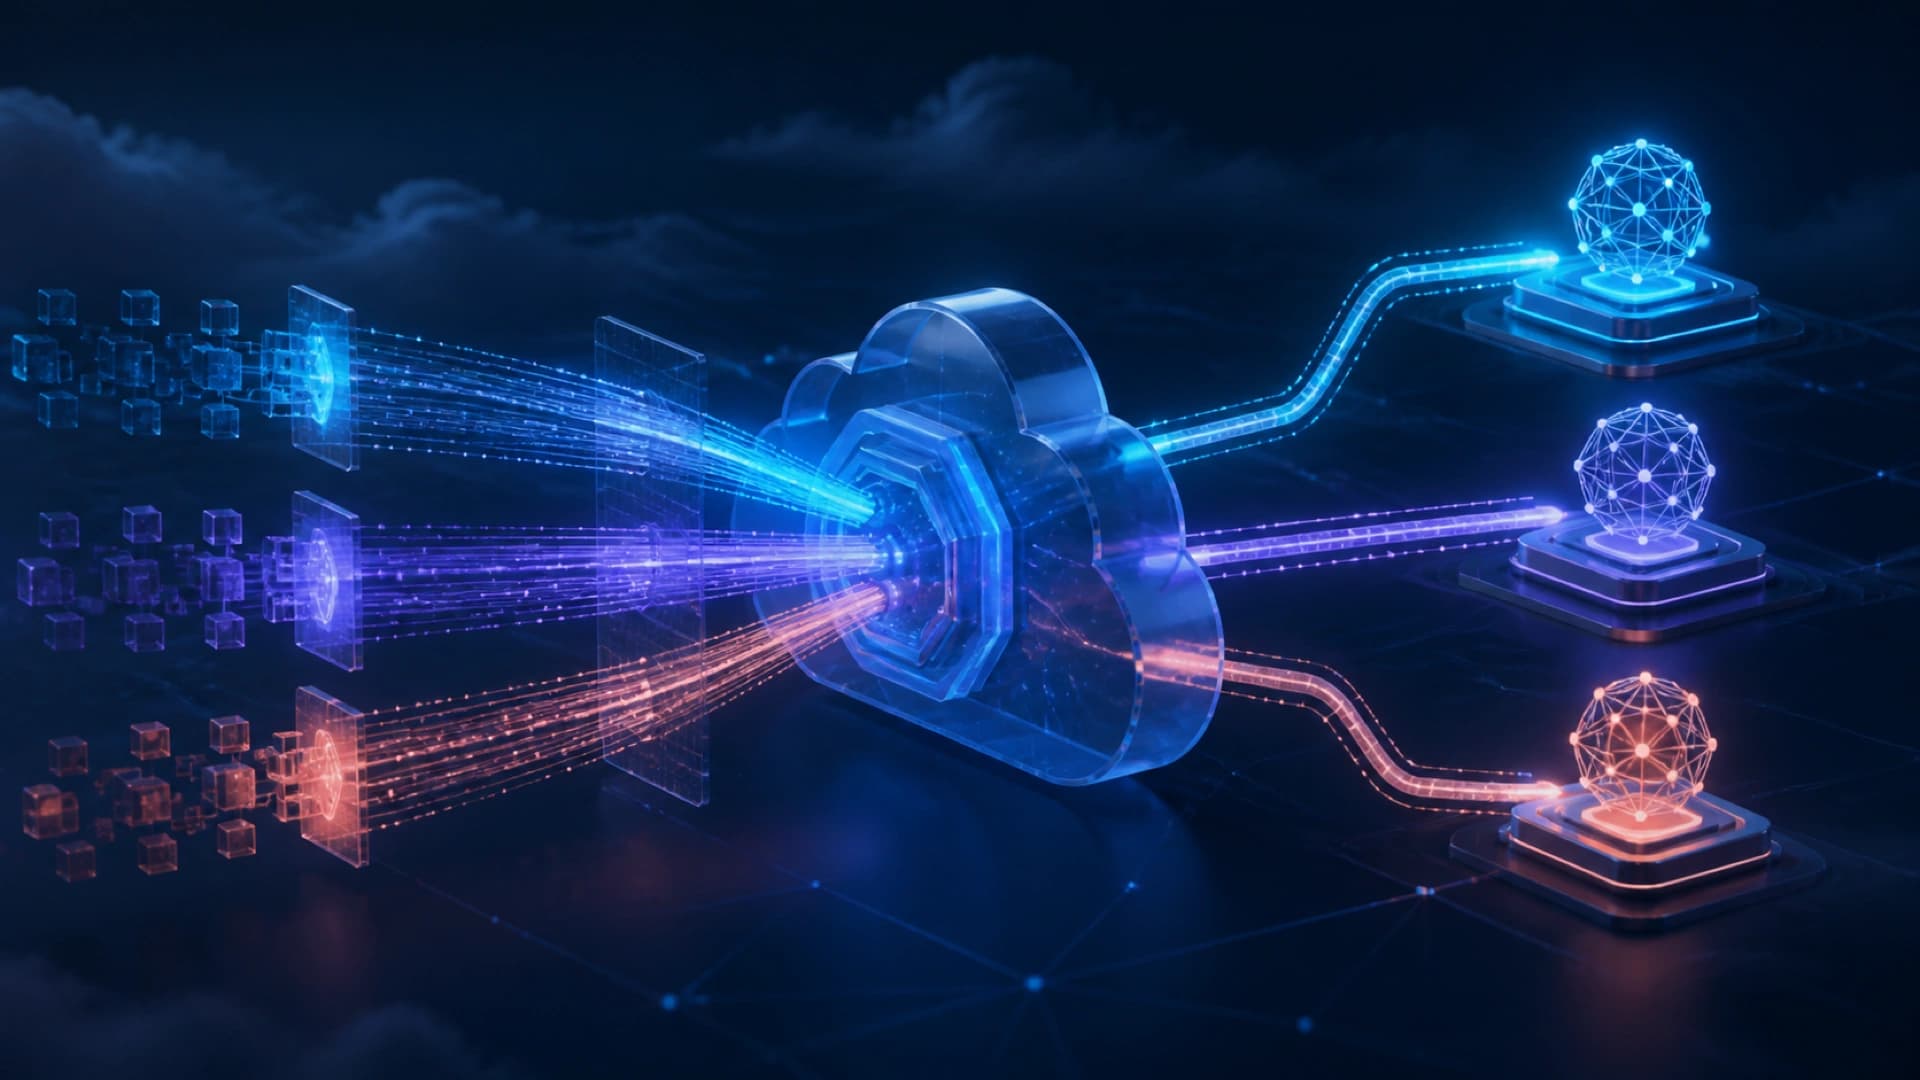
Google 在 2026 年 8 月 4 日宣布,Google Cloud API Gateway 的 model routing 進入 Public Preview。它是一層 managed、serverless 的 ingress,接受 OpenAI-compatible 請求,再按配置把請求轉送到 Vertex AI 上的 Gemini、Claude 或 open-weight GPT 模型。對開發者來說,應用程式可以維持一套請求介面,將模型選擇和部分 provider-specific 轉換放到 gateway。
路由規則可以把一個 default model 和多個 override rule 放在同一個 router 內。應用程式仍然發出標準化的 chat request,gateway 會根據 request 內的 model 名稱選擇後端,並把 OpenAI 格式轉成目標模型需要的 native schema。這種設計減少了應用程式直接管理多個 SDK、endpoint 和認證流程的需要。
這個位置很適合 agent 系統。Agent 往往會因應任務類型、延遲、成本或能力,在快速模型和較強模型之間切換;如果切換邏輯散落在每個 client,測試和治理會變得困難。由 gateway 統一接收請求,團隊可以把 rate limiting、token tracking、路由規則和 API 入口放在較接近基礎設施的一層,再由應用程式保留任務本身的決策。
但 model routing 仍然是 Public Preview,不能當作成熟的跨供應商抽象層。Google 的文件指出,同一 router 內的 backends 要共享相同 host;這個功能主要在同一個 Vertex AI endpoint 內改變模型和 path,不是任意把請求送往不同雲端。不同模型的工具呼叫、上下文限制、內容政策、計費和輸出格式,也不會因為有相同 API 入口而自動一致。
因此,團隊仍要保留 provider-specific 的驗證。路由成功不代表答案品質相同,也不代表 fallback 會保留完全相同的工具狀態。較穩妥的做法,是為每條路由記錄 model、延遲、token、錯誤和輸出評估,並把 preview 功能放在可替換的邊界,而不是把所有 agent 狀態綁死在 gateway 的實作細節上。
這項更新反映模型基礎設施的抽象層正在上移。過去開發者主要在 application code 內選模型;現在 cloud gateway 開始接管路由、轉碼、流量和部分治理。它可以降低多模型接入的工程成本,但真正的可移植性仍要靠應用程式自己的能力測試、成本策略和失敗處理來建立。