NVIDIA 於 2026 年 9 月 30 日分享一個以 NVIDIA NeMo 微調 Nemotron 3.5 ASR 的實驗,目標是改善 Saudi Arabic 的 Najdi 和 Hijazi 方言辨識。Nemotron 3.5 ASR 支援 40 個語言及 locale 的串流語音辨識;這篇 Technical Blog 的重點則是如何利用有限的方言資料,減少模型在特定部署語境中的錯誤。
文章描述的流程包括基本資料整理、把目標方言資料與 FLEURS 混合的 weighted replay、按音訊時長分桶,以及只解凍部分 encoder 層作微調。NVIDIA 表示,使用 133.7 小時 Najdi/Hijazi 資料後,目標測試分割的 word error rate(WER)由 55.05% 降至 29.96%;English WER 則由 11.04% 變為 10.42%,其他 Arabic dialects 沒有出現退化。這些數字是該教學實驗的結果,不能直接視為所有資料集和產品環境都會得到的幅度。
微調配置之間有明顯取捨。文章指出,解凍全部 24 個 encoder layers 得到最低錯誤率,但要訓練約 230.4 百萬個參數;凍結較多層可以降低計算量,卻可能犧牲適應效果。weighted replay 的目的,是讓模型學習新方言時仍然接觸原有語言資料,減少過度偏向目標資料的風險,但它只能保護被納入 replay 的分布,不能替代對實際使用者、設備、噪音和專業詞彙的評估。
對串流場景,NVIDIA 亦測試 lookahead 和 beam search。文中表示,使用 13 個 lookahead、beam-8 的 MALSD 配置,在不重新訓練的情況下把 WER 再降低 2.71 個百分點,但批次轉錄的延遲約為 800 毫秒。這反映語音系統不是只追求離線準確率:即時客服、會議字幕和語音控制要在錯誤率、延遲、GPU 成本和使用者體驗之間取平衡。
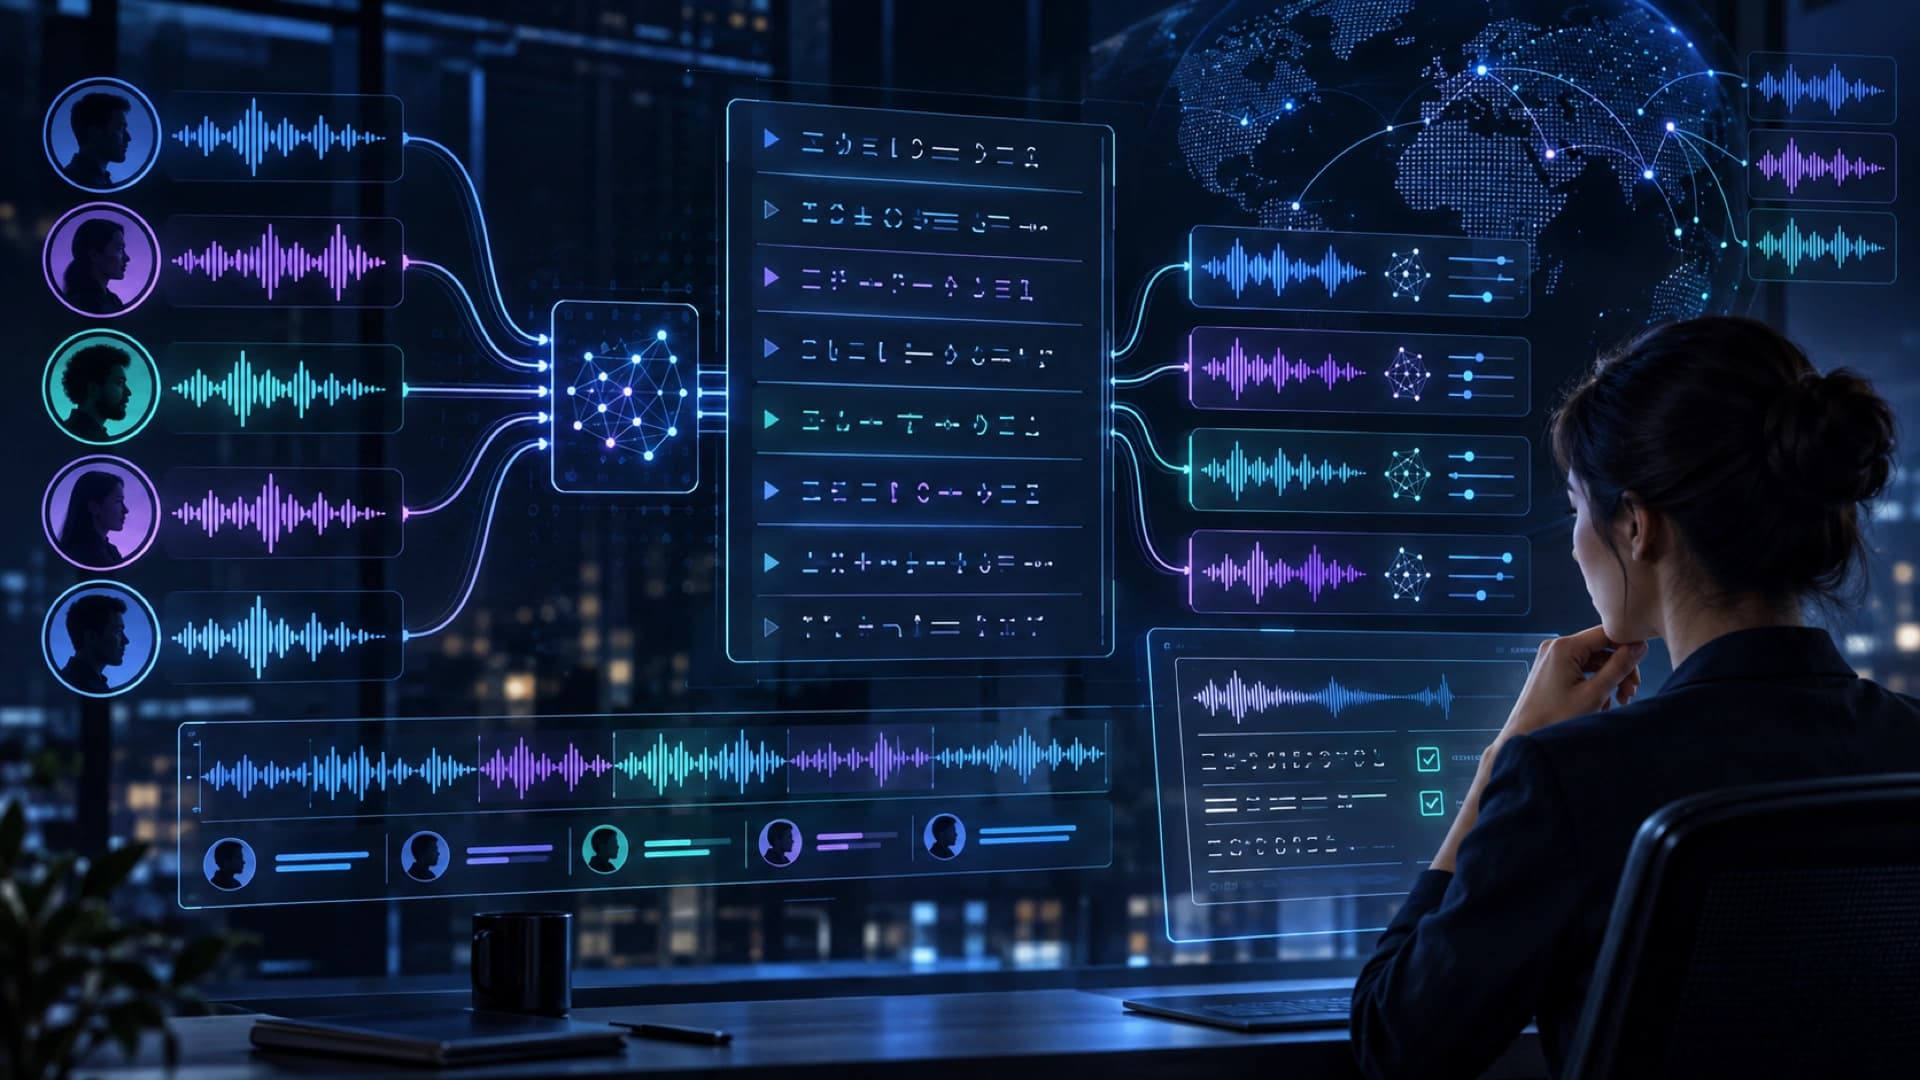
Nemotron 3 diarization 也被放在同一個部署路徑中,最多支援 8 名說話者分離。對多方通話或會議而言,分辨「誰在甚麼時間說了甚麼」可以令後續摘要、工單建立及合規稽核更有用,但說話者分離錯誤會連鎖影響文字內容和責任歸屬,所以仍需要在目標語言、口音和錄音環境中獨立測試。
這篇文章的實務價值,在於展示方言適配需要一條完整的評估鏈:先確認資料是否代表真實使用情境,再比較 replay、解凍層數和推理設定,最後同時量度目標方言、其他語言、延遲和資源成本。NVIDIA 的結果提供一個可重現的起點,但它是供應商技術教學和實驗報告,不應被解讀成 Saudi Arabic 或其他語言部署的通用保證。