Google DeepMind 在 2026 年 8 月 12 日發布 sign-language-to-text 模型 SL2T,並把它帶進 Gboard 和 Pixel 11 的 Live Transcribe。首階段支援 American Sign Language 到英文,Google 表示更多裝置和語言會陸續加入。這次更新的重點,不只是新增一個翻譯模型,而是讓 Deaf 和 hard of hearing 使用者可以在原本打字的位置直接用手語輸入。
SL2T 可把手語轉成文字,讓使用者用手語搜尋網頁、撰寫訊息或文件,也可以要求 Gemini 解答問題或執行任務。在 Live Transcribe 裡,使用者可以用手語回應對話,減少雙方反覆打字。這些是 Google 描述的產品場景;實際可用性仍取決於裝置、語言、手語熟練程度和現場影像條件。
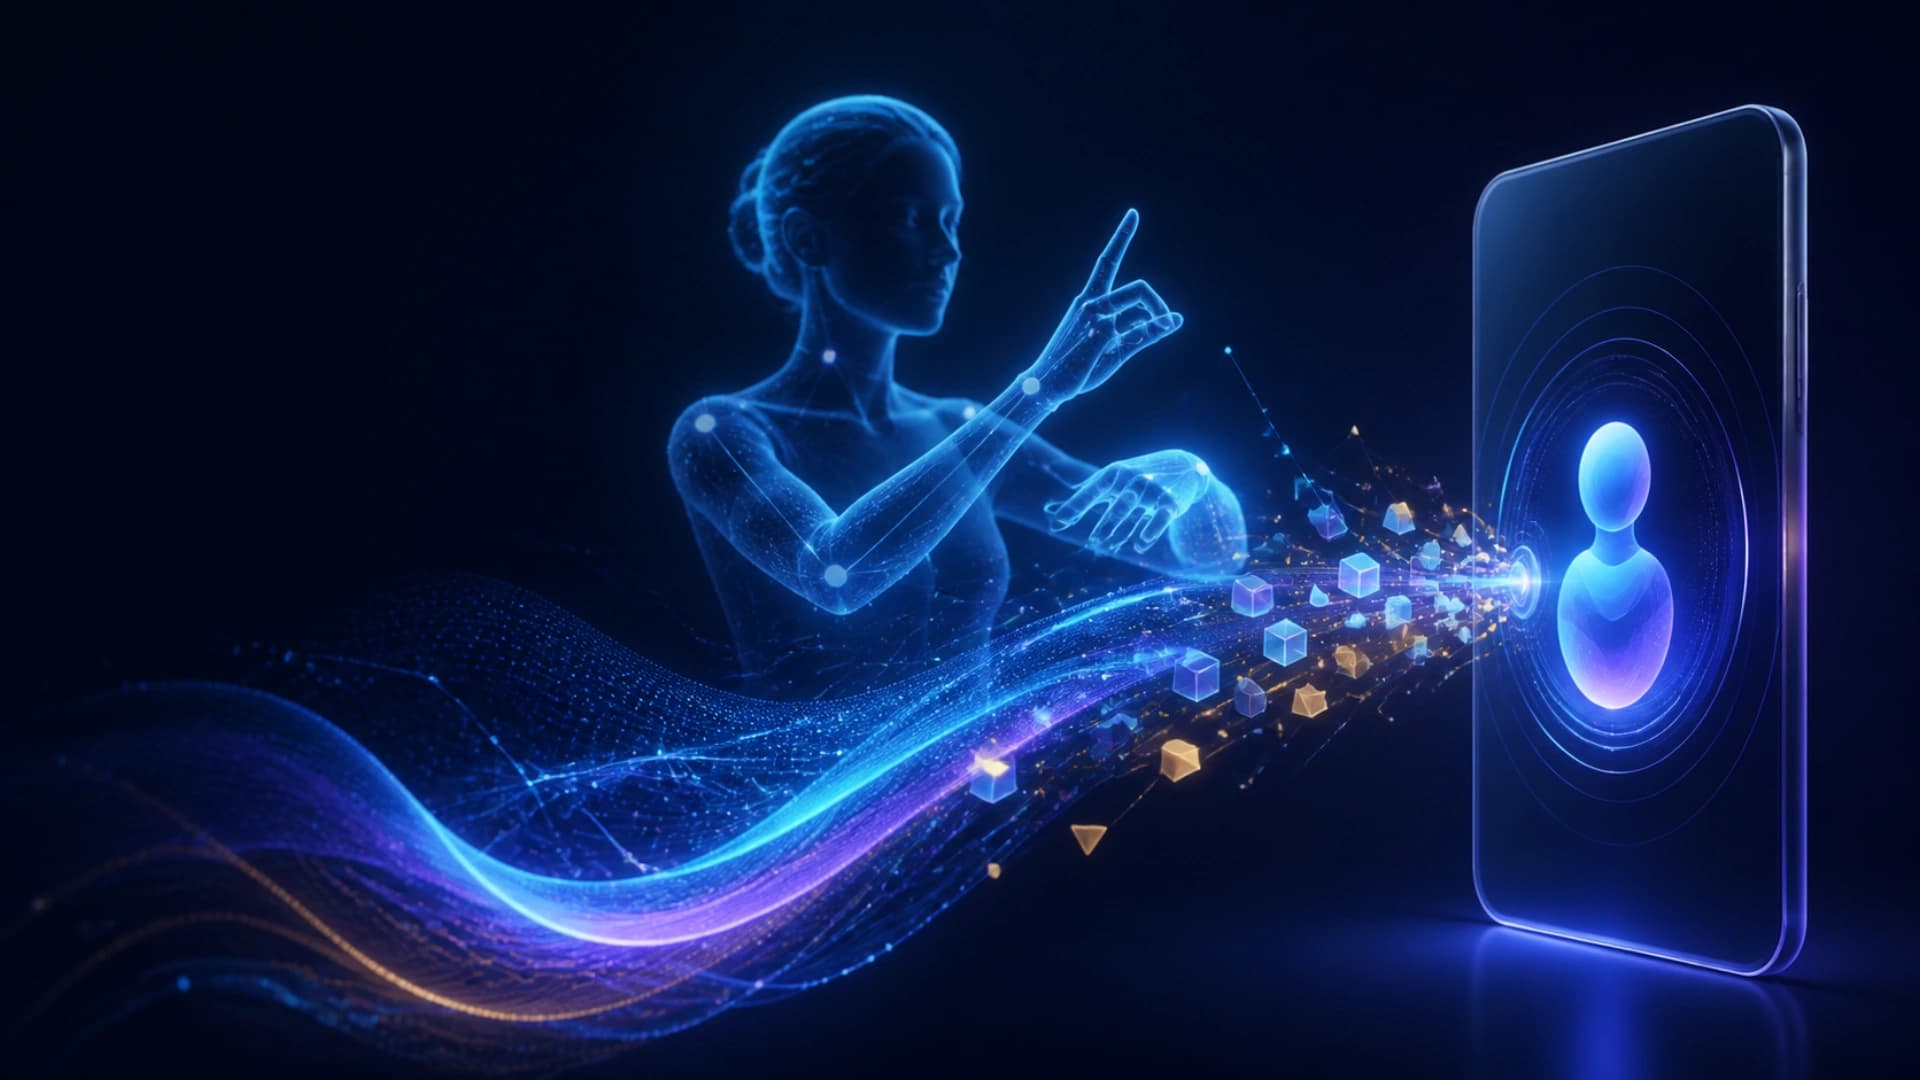
手語翻譯不是把英文詞語逐個映射到手部動作。Google DeepMind 指出,手語是有自身 grammar 和 lexicon 的自然語言,意思同時由手、手臂、軀幹、頭部和面部動作傳遞;模型要處理高幀率、細微和同步的 computer vision 訊號。這使它更接近真正的 machine translation,而不是簡單的 gesture recognition。
在 privacy 設計上,SL2T 不直接把原始 camera feed 送往伺服器。Google 表示,裝置上的 MediaPipe Holistic 先把手語轉成 signer body 的 pose landmark coordinates,再把幾何座標送到伺服器翻譯,原始影片可以即時丟棄。這種設計降低了原始影像留存風險,但仍然需要說明座標、傳輸、服務端處理和帳戶資料如何受保護。
Google DeepMind 表示,模型使用超過 100,000 小時、覆蓋 50 多種手語的資料訓練,其中約四分之一是 ASL;團隊認為多語言訓練有助模型學到共享結構。Google 也報告 SL2T 在 FLEURS-ASL 的 zero-shot score 達到 70 BLEURT,並稱是目前最強的手語翻譯模型。這是 Google 公布的 benchmark 結果,不能取代不同社群、方言、速度和真實對話中的 user study。
產品化時,團隊另外處理 streaming latency、非手語輸入時的 hallucination、左手使用者,以及一隻手拿手機時的 one-handed signing。Google 也表示與 Deaf community 共建,成立 AI Sign Language Advisory Committee,並把能力和限制寫入 joint impact report。這些治理安排很重要,因為手語科技的品質不只由 BLEURT 分數決定,也由使用者能否自然、可靠和有尊嚴地使用決定。
SL2T 的更大訊號,是 multimodal AI 正由「看得懂影像」走向「以使用者自己的語言直接操作數碼服務」。當手語輸入可以接到搜尋、文件和 Gemini task execution,accessibility feature 也開始具備 agent interface 的特性。下一步的評估應包括不同手語、方言、單手和快速 signing 的準確度、延遲、錯誤後果、影像處理透明度和使用者能否隨時控制資料。